Divergensi Kullback-Leibler (KL)
Sepanjang tahap post-training LLM, terdapat banyak keadaan ketika kita mengoptimalkan model menggunakan regularisasi KL. Sebagai contoh, fungsi tujuan optimasi standar yang digunakan dalam RLHF memiliki bentuk dengan regularisasi KL sebagaimana ditunjukkan di bawah ini.
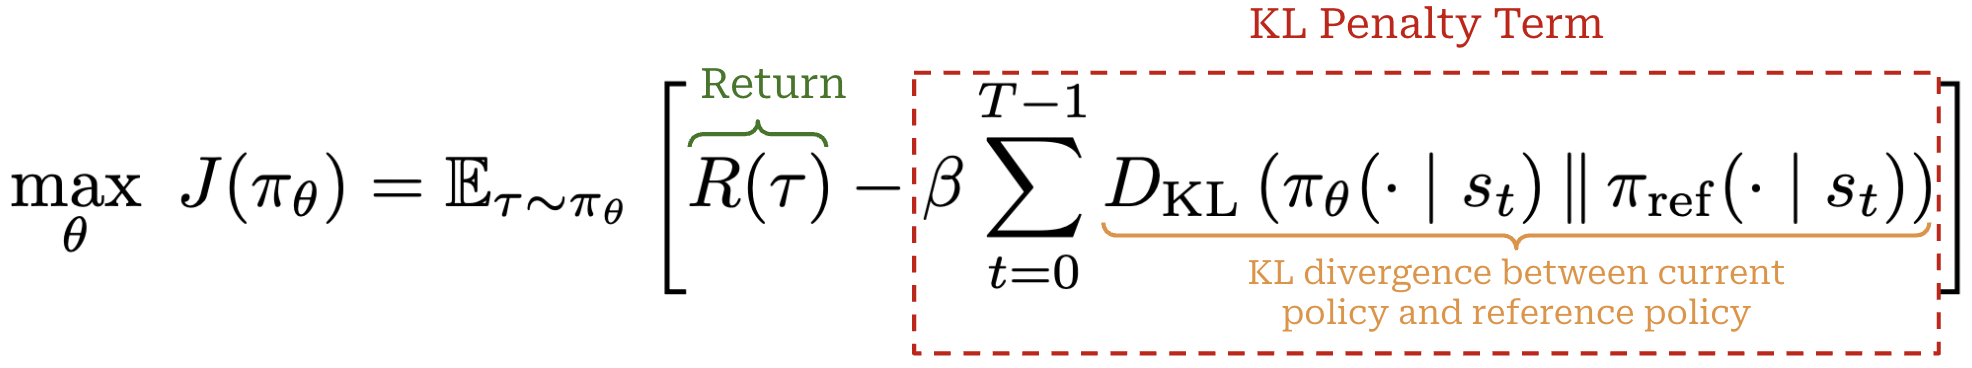
Seperti yang dapat kita lihat, kita ingin memaksimalkan reward sekaligus meminimalkan suatu suku penalti—divergensi KL yang diberi bobot β—yang dikurangkan dari reward tersebut. Tujuan suku penalti ini adalah mencegah policy kita menyimpang terlalu jauh dari reference policy (policy acuan) selama pelatihan. Dalam praktiknya, penalti KL ini dimasukkan ke dalam proses optimasi RL dengan salah satu dari dua cara berikut:
- Dengan langsung mengurangkan penalti KL dari reward.
- Dengan menambahkan penalti KL ke dalam loss function (fungsi kerugian).
Dalam tinjauan ini, kita akan melihat divergensi KL digunakan dalam RL melalui kedua pendekatan tersebut. Sebagai contoh, implementasi awal RLHF berbasis PPO memasukkan KL terhadap reference policy ke dalam reward, sedangkan formulasi GRPO yang asli menambahkan penalti KL secara langsung ke dalam fungsi tujuan. Penggunaan divergensi KL secara tepat berbeda-beda, bergantung pada ranah penerapannya. Meskipun terdapat banyak bentuk regularisasi untuk pelatihan LLM, divergensi KL telah lama menjadi komponen yang bertahan dan mendasar dalam pelatihan RL5. Karena alasan inilah, kita akan membahas rincian penting divergensi KL serta bagaimana konsep tersebut digunakan dalam praktik.
Divergensi KL merupakan konsep dari teori informasi (information theory) yang mengukur seberapa berbeda suatu distribusi probabilitas dari distribusi acuan tertentu. Divergensi KL tidak simetris—urutan argumennya berpengaruh. Divergensi KL memiliki bentuk seperti yang ditunjukkan di bawah ini, baik untuk distribusi probabilitas diskret maupun kontinu.
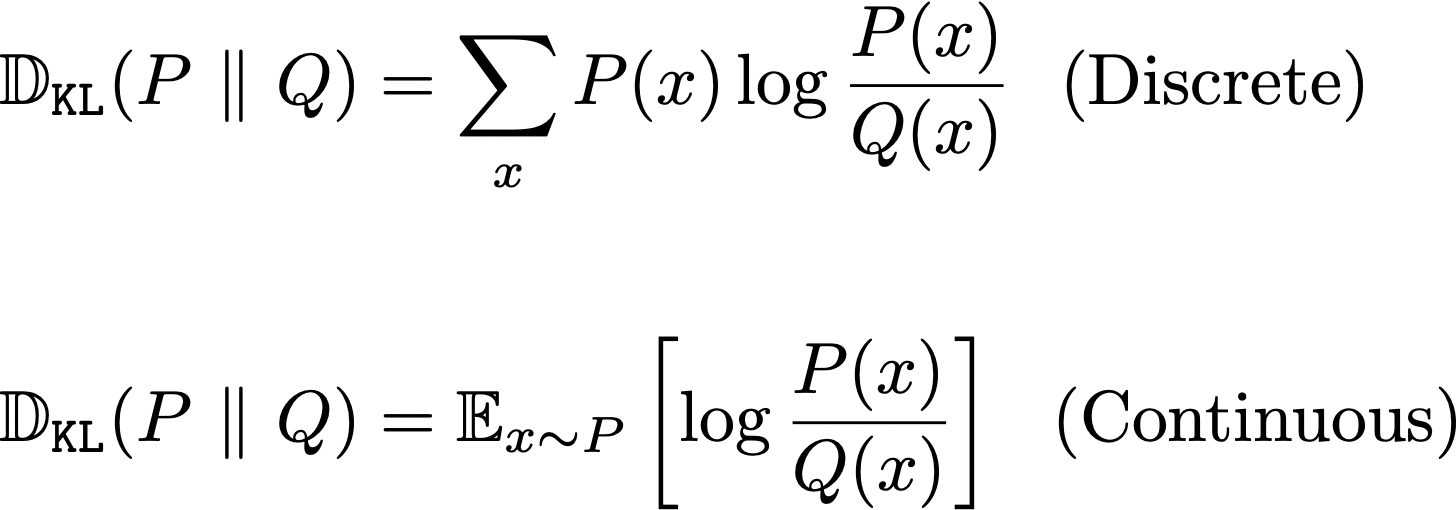
Hubungannya dengan LLM. Dalam ranah LLM, divergensi KL lazim digunakan untuk membandingkan beberapa LLM atau policy—biasanya policy yang sedang kita latih dan suatu reference policy (misalnya, policy sebelum pelatihan RL). Secara khusus, kita menghitung divergensi KL di antara distribusi probabilitas token berikutnya yang dihasilkan kedua LLM tersebut. Untuk memahami hal ini dengan lebih baik, mari kita perhatikan satu posisi t dalam sebuah urutan. Pada posisi tersebut, kedua LLM memprediksi distribusi probabilitas atas seluruh kosakata token yang mungkin menjadi token berikutnya. Selanjutnya, kita dapat secara eksplisit menghitung divergensi KL di antara kedua distribusi probabilitas tersebut, sebagaimana ditunjukkan pada ilustrasi berikut dalam artikel asli. Perlu diperhatikan bahwa persamaan ini tidak lain adalah formulasi diskret divergensi KL yang telah diuraikan sebelumnya.
Secara intuitif, divergensi KL mengukur seberapa jauh distribusi probabilitas token berikutnya pada policy saat ini telah bergeser dibandingkan dengan reference policy ketika berada pada keadaan s_t. Untuk mengukur divergensi pada keseluruhan completion, kita dapat menjumlahkan suku-suku KL pada berbagai posisi token. Secara lebih umum, KL pada tingkat urutan diperoleh dengan mengambil nilai harapan dari suku-suku tersebut atas keadaan-keadaan yang diambil sebagai sampel dari policy saat ini.
Memperkirakan divergensi KL dalam praktik. Menghitung divergensi KL yang tepat mengharuskan kita membandingkan seluruh distribusi kosakata yang dihasilkan policy saat ini dan reference policy pada setiap posisi token. Mengingat kita sering bekerja dengan kosakata yang besar serta urutan yang panjang pada LLM, menyimpan dan menangani seluruh distribusi token tersebut akan menyebabkan peningkatan besar pada kebutuhan komputasi dan memori. Dalam praktiknya, algoritma RL sering menggunakan estimator Monte Carlo untuk divergensi KL yang lebih murah dan hanya membutuhkan log-probabilitas token-token yang diambil sebagai sampel dalam completion. Biasanya, kita menyebutnya estimasi divergensi KL berbasis sampel (sampled estimate).
Karena divergensi KL dapat dituliskan sebagai nilai harapan berdasarkan policy saat ini, mengambil sampel tindakan dari π_θ, menghitung rasio log-probabilitasnya, lalu merata-ratakannya di seluruh sampel akan menghasilkan estimasi Monte Carlo bagi divergensi KL yang sebenarnya. Berikutnya, kita akan membahas beberapa pilihan cara memperkirakan divergensi KL, dengan menggunakan notasi dari rujukan [4] dalam pembahasan tersebut.
Catatan Kaki Penulis
5 Namun, penelitian terbaru mengenai pelatihan RL untuk model penalaran menggunakan penalti KL lebih jarang dibandingkan dengan prosedur pelatihan RL sebelumnya untuk LLM. Dalam pelatihan RL berskala besar semacam itu, mempertahankan policy saat ini tetap dekat dengan reference policy mungkin terlalu membatasi—kita mungkin justru menginginkan perubahan besar pada policy selama pelatihan RL.
Sumber asli: Cameron R. Wolfe, Ph.D., Reinforcement Learning for LLMs: The Complete Guide, 24 Agustus 2026. Terjemahan Bahasa Indonesia untuk FLOWER — komputrobotika.com.
Bersambung ke bagian berikutnya, in sya Allah