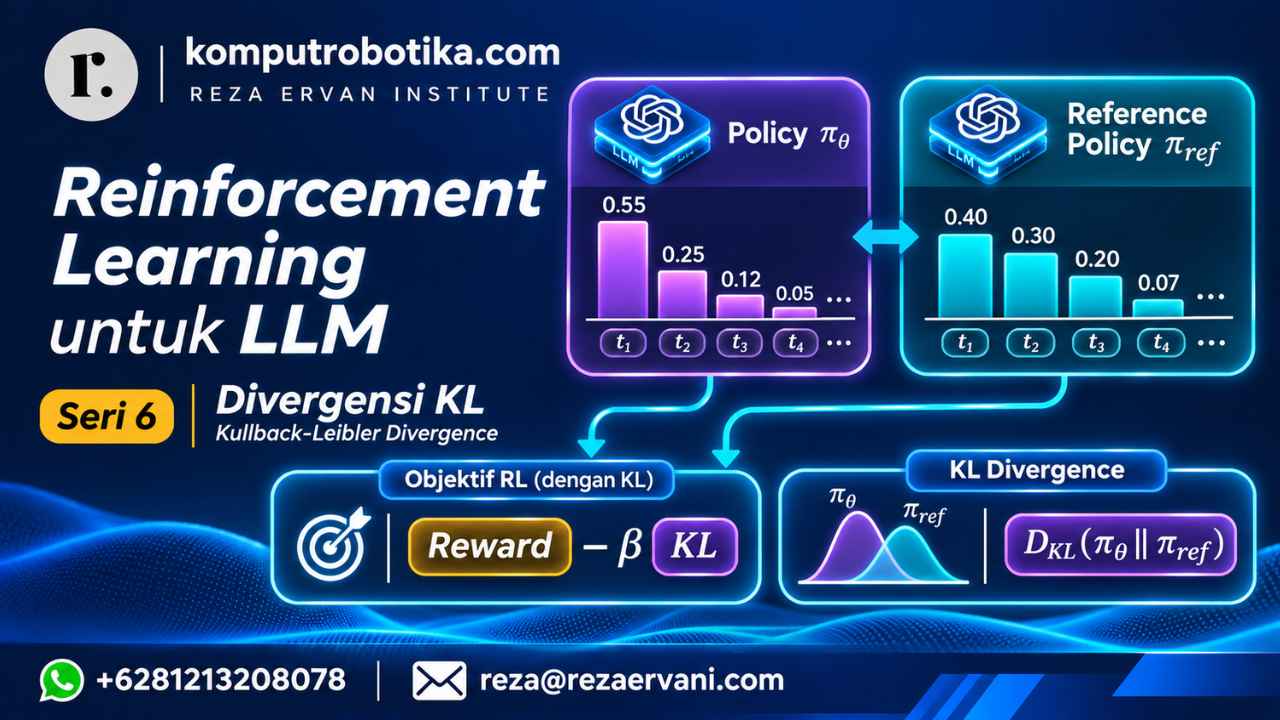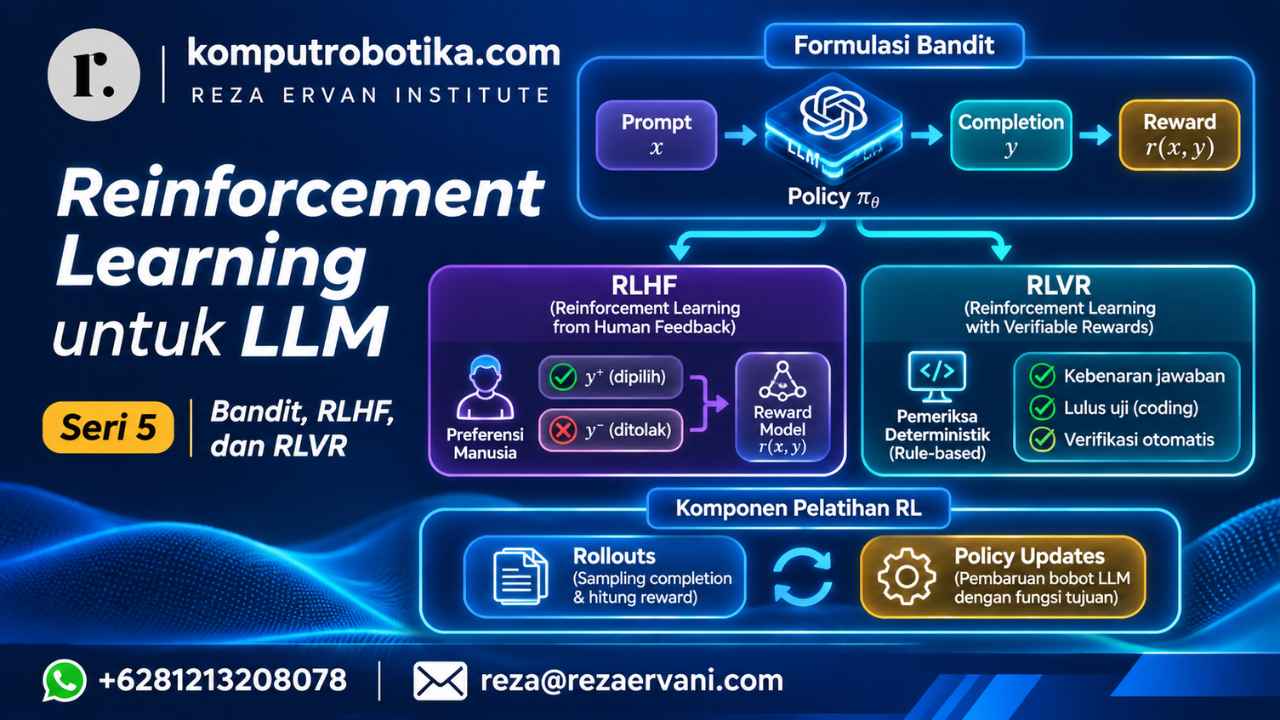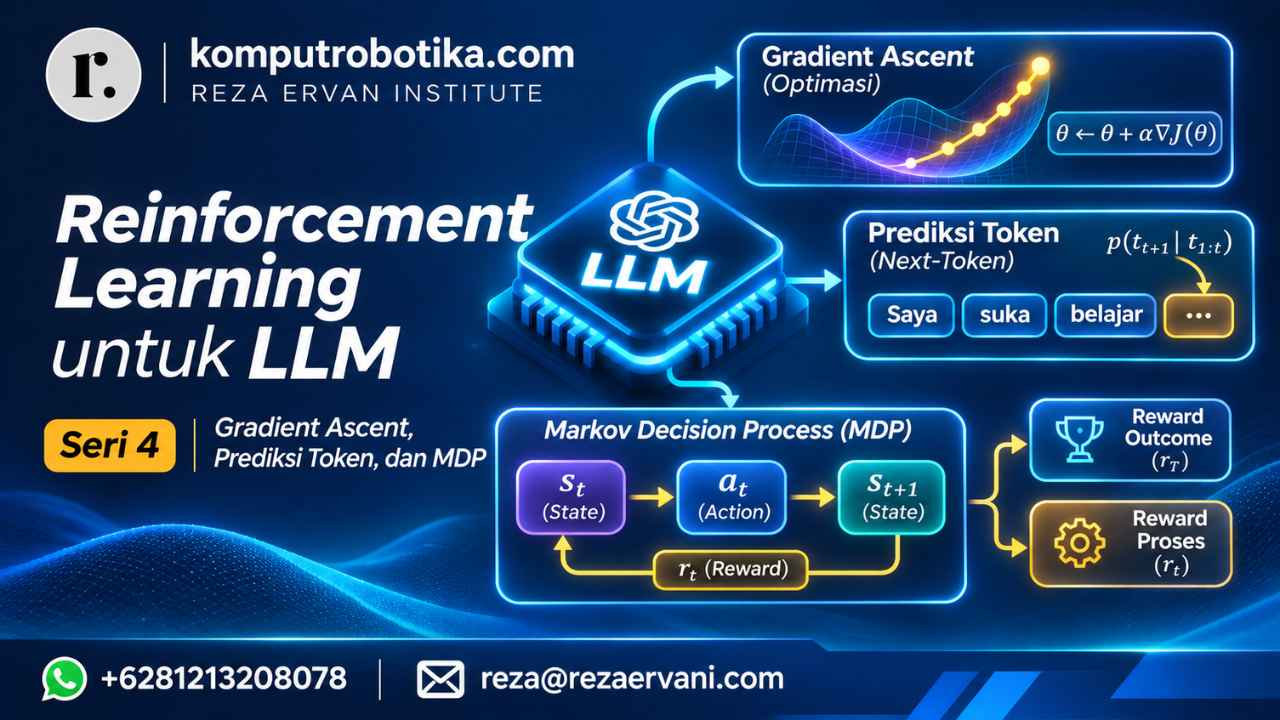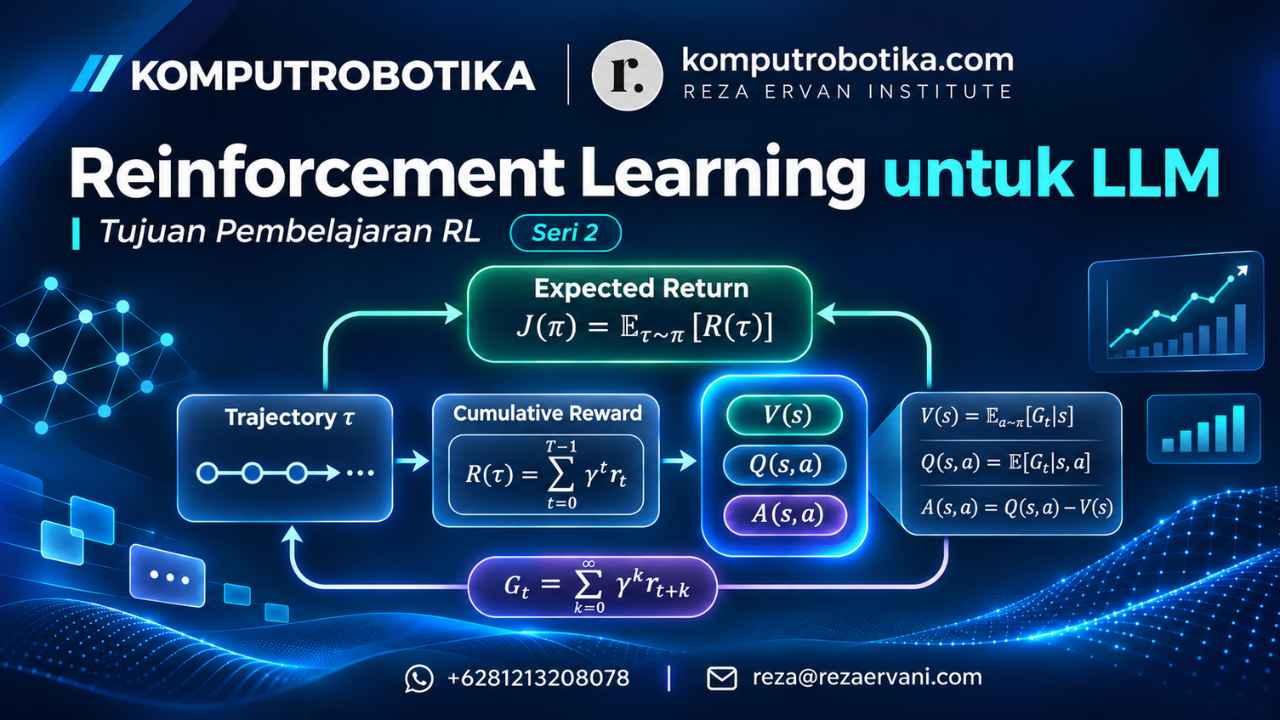
Kita bahkan dapat merumuskan tujuan RL dalam bentuk value function, sebagaimana ditunjukkan pada gambar di bawah ini. Persamaan tersebut setara dengan perumusan tujuan RL sebelumnya yang menggunakan return berbasis trajectory. Dalam hal ini, kita menyatakan tujuan sebagai nilai harapan yang dimulai dari suatu keadaan yang diambil sebagai sampel dari distribusi keadaan awal.
J(θ) = Es₀ ∼ d₀[Vπθ(s₀)]
Action-value function mirip dengan value function karena sama-sama mengondisikan perhitungannya pada keadaan s. Namun, action-value function juga mengondisikan perhitungannya pada tindakan a yang dilakukan dalam keadaan tersebut. Dengan demikian, kedua fungsi ini sama-sama mengukur expected return, tetapi nilai harapannya dihitung berdasarkan kondisi yang berbeda.
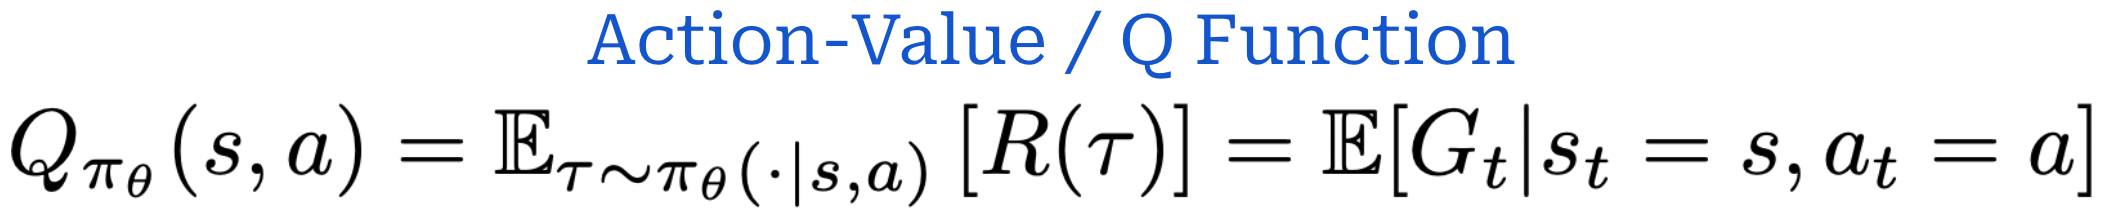
Advantage function menangkap kegunaan relatif dari tindakan a. Secara intuitif, V(s) menunjukkan expected return ketika kita bertindak sesuai dengan policy mulai dari keadaan s, sedangkan Q(s, a) menunjukkan expected return ketika kita:
- Memulai dari keadaan
s. - Secara khusus melakukan tindakan
a. - Setelah itu, bertindak sesuai dengan policy kita.
Selisih kedua besaran tersebut, A(s, a) = Q(s, a) - V(s), mengukur perbedaan antara expected return dari keadaan s dan expected return dari keadaan s setelah secara khusus melakukan tindakan a. Dengan menghitung selisih tersebut, advantage function secara intuitif menunjukkan seberapa jauh tindakan a lebih baik atau lebih buruk dibandingkan dengan kinerja yang diharapkan dari policy pada keadaan s. Advantage bernilai positif ketika expected return setelah tindakan a lebih tinggi daripada yang diharapkan dari keadaan s, dan sebaliknya. Sebagaimana akan kita pelajari, advantage function memainkan peran yang sangat besar dalam penelitian RL.
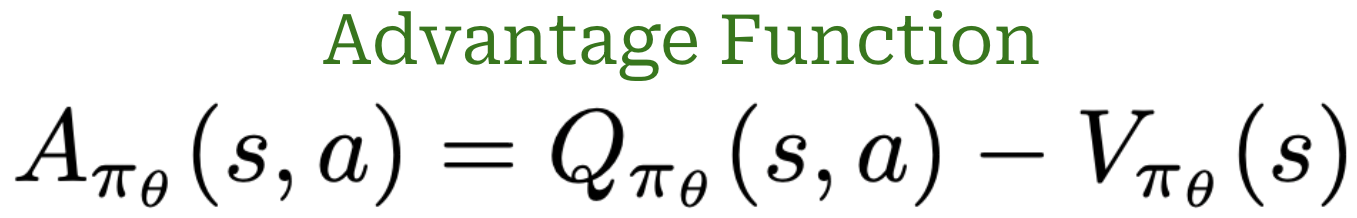
“Terkadang dalam RL, kita tidak perlu menggambarkan seberapa baik suatu tindakan secara mutlak, melainkan hanya seberapa jauh tindakan tersebut lebih baik dibandingkan tindakan lainnya secara rata-rata. Dengan kata lain, kita ingin mengetahui keunggulan relatif dari tindakan tersebut. Kita membuat konsep ini menjadi tepat melalui advantage function.” — Spinning Up in Deep RL
Estimasi value dan advantage. Kita telah merumuskan value function, action-value function, dan advantage function di atas sebagai nilai harapan. Namun, dalam praktiknya nilai harapan ini biasanya tidak dapat dihitung secara tepat—kita memerlukan cara untuk memperkirakannya. Pendekatan yang wajar adalah menggunakan informasi dari trajectory nyata yang diambil sebagai sampel dari policy saat ini. Secara khusus, return teramati G_t setelah melakukan tindakan a_t memberikan estimasi Monte Carlo atas action-value function Q(s_t, a_t).
Secara intuitif, G_t menunjukkan apa yang benar-benar terjadi setelah tindakan tertentu a_t dilakukan pada keadaan s_t. Return dari satu sampel merupakan estimasi Q(s_t, a_t) yang mengandung derau. Untuk mengurangi varians estimasi ini, kita juga dapat menghitung rata-rata return dari beberapa sampel. Di sisi lain, value function V(s_t) menunjukkan expected return dari keadaan s_t sebelum kita memutuskan tindakan tertentu a_t. Ketika menggunakan metode policy gradient, kita akan menjumpai dua pendekatan untuk memperkirakan value function:
- Kita dapat menghindari estimasi value function secara eksplisit dan sebagai gantinya memperkirakan advantage function dengan mengurangkan baseline sederhana—seperti rata-rata return dalam satu batch—dari action-value function.
- Kita dapat secara langsung memperkirakan value function menggunakan value model yang dipelajari, yang juga disebut critic.
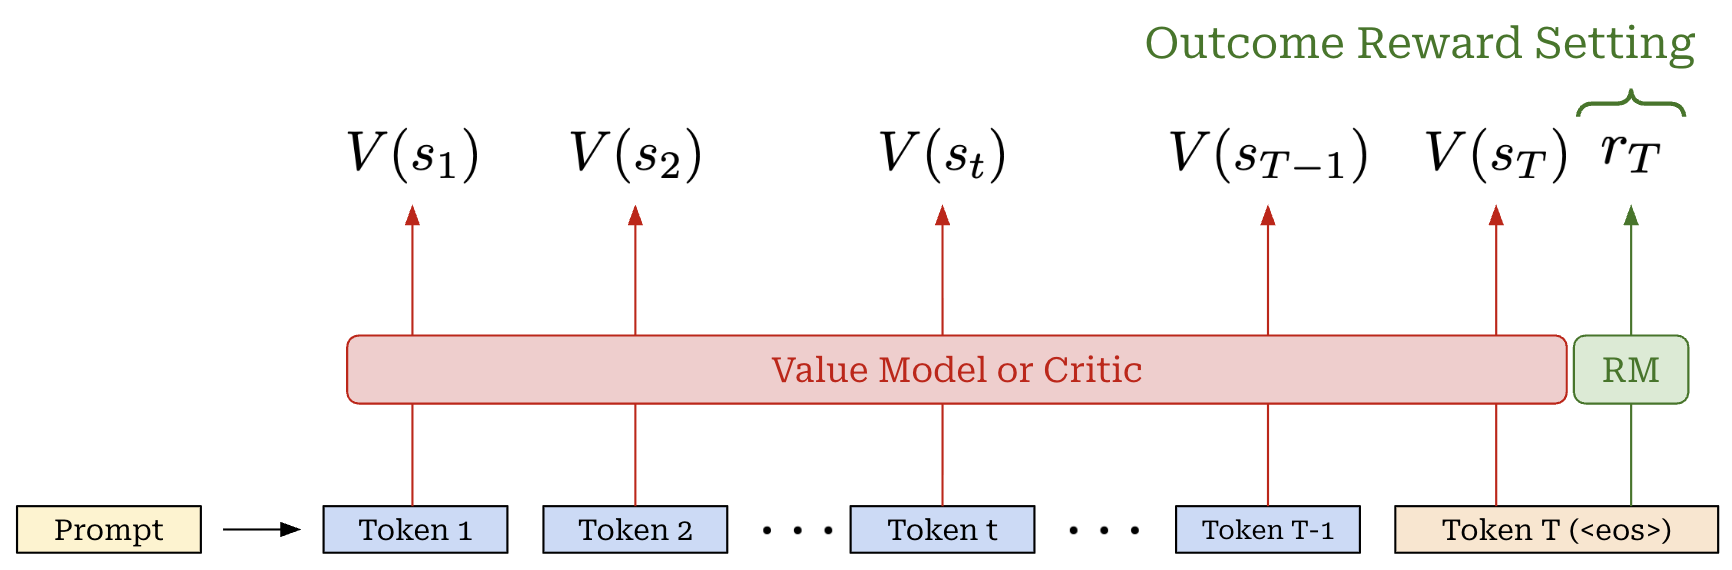
Dalam ranah LLM, critic biasanya diimplementasikan menggunakan arsitektur dasar LLM dengan tambahan scalar value head—arsitektur ini sangat mirip dengan reward model. Namun, berbeda dengan reward model, critic memprediksi expected return di masa depan untuk setiap posisi token—atau keadaan—di dalam urutan, bukan satu reward untuk keseluruhan urutan. Karena kita menggunakan LLM dengan arsitektur decoder-only (kausal), representasi LLM pada setiap posisi t hanya bergantung pada token-token sebelumnya. Oleh karena itu, satu forward pass dapat menghasilkan perkiraan value untuk setiap token dalam trajectory; lihat di bawah ini. Meskipun kita akan mempelajari lebih banyak rincian nanti dalam tulisan ini, critic dilatih bersama policy melalui regression loss antara prediksinya dan return yang benar-benar diamati.
Dari sini, kita dapat menyusun estimasi sederhana untuk advantage function; lihat di bawah ini. Karena A(s_t, a_t) = Q(s_t, a_t) - V(s_t), kita dapat memperkirakan advantage dengan menghitung selisih antara G_t—estimasi berbasis sampel untuk Q(s_t, a_t)—dan keluaran value model kita—perkiraan V(s_t).
# B - ukuran batch
# L - panjang urutan

# return sampel dari setiap keadaan/tindakan
returns = ...                                      # (B, L)

# perkiraan value untuk setiap keadaan
values = critic(states)                            # (B, L)

# hitung estimasi advantage
advantages = returns - values.detach()             # (B, L)
Secara intuitif, G_t memberi tahu kita apa yang benar-benar terjadi setelah tindakan a_t, sedangkan value model memprediksi apa yang kita harapkan akan terjadi dari keadaan s_t. Karena itu, selisih keduanya memperkirakan apakah tindakan yang diambil menghasilkan hasil yang lebih baik atau lebih buruk daripada yang diharapkan. Seperti yang akan kita lihat, algoritma RL berbeda dalam cara memperkirakan return, value, dan advantage, tetapi semua estimasi tersebut dibangun di atas besaran-besaran dasar yang sama seperti yang telah didefinisikan di atas.
Sumber asli: Cameron R. Wolfe, Ph.D., Reinforcement Learning for LLMs: The Complete Guide, 24 Agustus 2026. Terjemahan bahasa Indonesia untuk FLOWER — komputrobotika.com.
Bersambung ke bagian berikutnya, in sya Allah