Mengoptimalkan Tujuan Pembelajaran
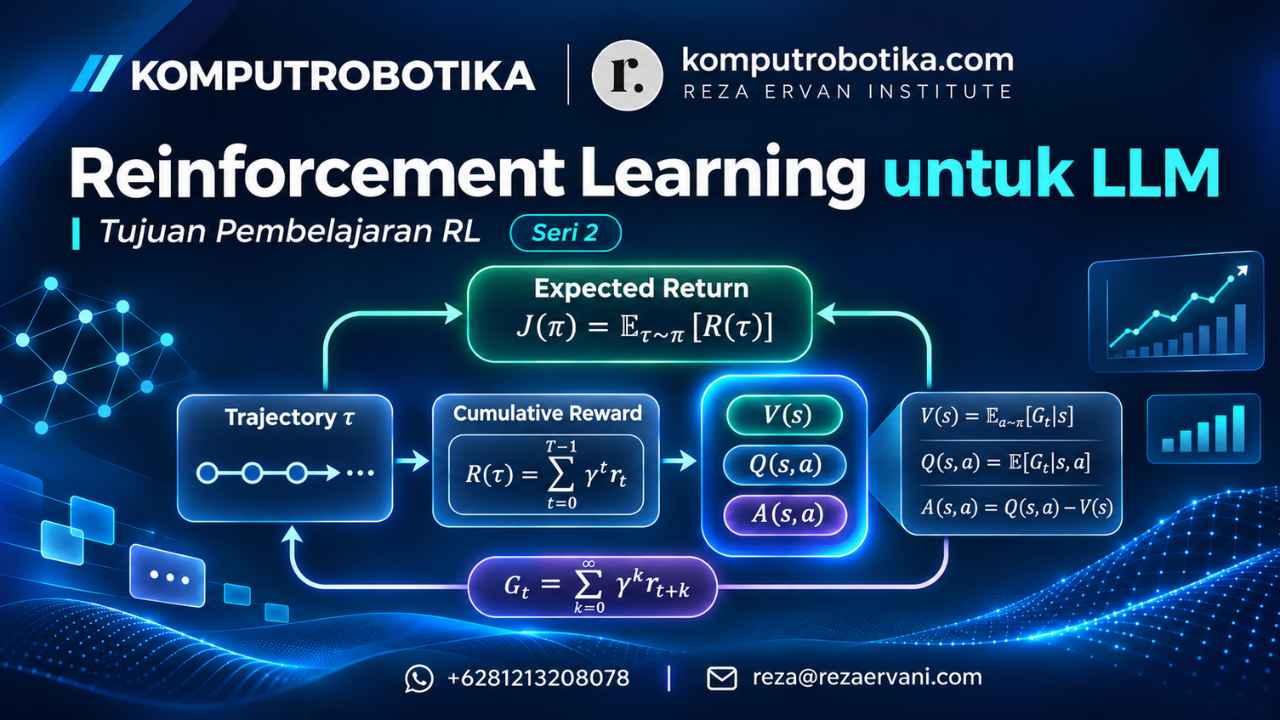
Mengoptimalkan tujuan. Kita ingin memaksimalkan tujuan RL selama pelatihan—policy kita seharusnya menghasilkan trajectory dengan return yang tinggi. Sama seperti tujuan pembelajaran lainnya, expected return dapat dimaksimalkan menggunakan gradient ascent; lihat di bawah ini.
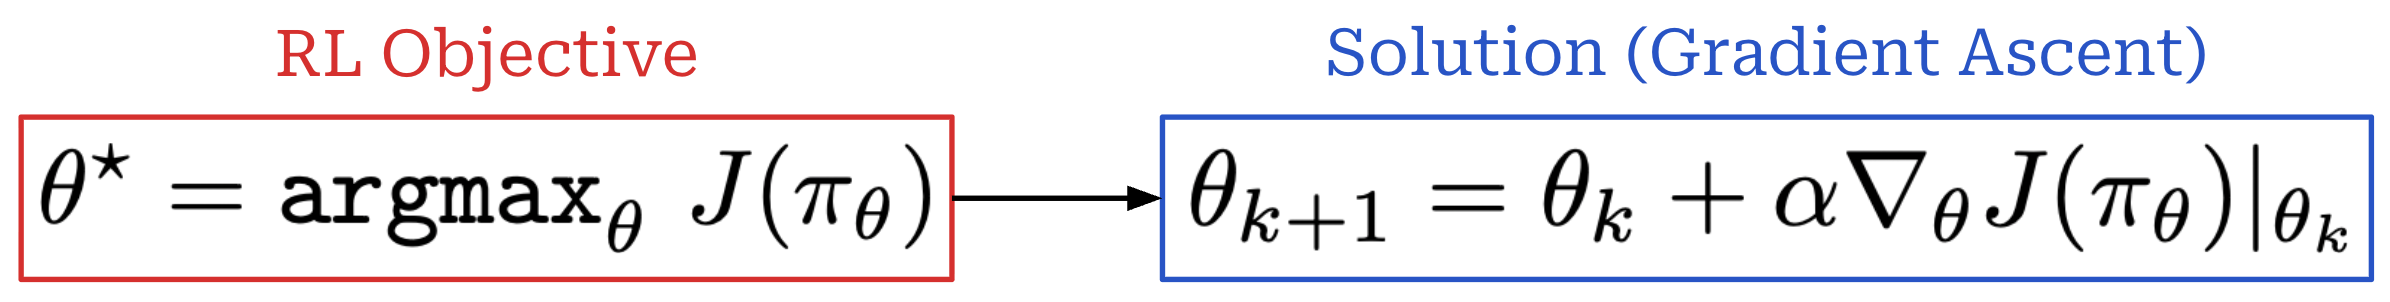
Namun, untuk melakukan gradient ascent, kita harus dapat menghitung gradien dari tujuan ini terhadap parameter policy kita. Dalam penelitian RL, kita menyebutnya policy gradient, dan ada banyak cara untuk memperkirakan policy gradient tersebut. Bahkan, hampir semua algoritma yang akan kita pelajari dalam tinjauan ini merupakan algoritma policy gradient: algoritma-algoritma itu mengusulkan teknik tertentu untuk menghitung policy gradient, kemudian mengoptimalkan policy melalui gradient ascent. Dalam ranah LLM, algoritma policy gradient sejauh ini merupakan pilihan yang paling umum untuk pelatihan RL.
Merumuskan RL untuk LLM
Pemetaan istilah-istilah RL ke ranah LLM. Setelah memahami dasar-dasar RL, kita perlu memetakan konsep-konsep yang telah dipelajari ke dalam pelatihan LLM secara khusus. Bahkan dalam ranah LLM, RL mengikuti kerangka dasar yang sama seperti yang telah kita lihat sebelumnya. Dimulai dari suatu keadaan awal, policy kita melakukan tindakan secara berulang hingga keadaan terminal tercapai, sehingga menghasilkan trajectory akhir. Seperti ditunjukkan pada ilustrasi di atas dalam artikel asli, istilah-istilah tersebut dipetakan ke ranah LLM sebagai berikut:
- Policy kita adalah LLM itu sendiri.
- Keadaan awal kita adalah prompt.
- Bergantung pada perumusannya, suatu tindakan dapat berupa satu token atau keseluruhan completion.
- Keadaan kita adalah gabungan prompt dengan token-token yang telah dihasilkan sejauh ini.
- Keseluruhan completion yang dihasilkan LLM membentuk sebuah trajectory.
Kerangka ini tidak lain adalah next-token prediction. Dengan sebuah prompt awal, policy kita—yakni LLM yang sedang dilatih—melakukan tindakan dengan menghasilkan token-token secara autoregresif dalam suatu pengulangan; lihat ilustrasi pada artikel asli. Pada akhirnya, suatu keadaan terminal tercapai (misalnya, token penanda akhir urutan atau end-of-sequence token), sehingga proses generasi selesai. Trajectory yang dihasilkan dari proses ini mencakup prompt beserta seluruh urutan token yang dihasilkan LLM.
Perlu diperhatikan bahwa fungsi transisi dalam kerangka ini bersifat deterministik. Dimulai dengan prompt x, jika LLM kita memprediksi token t_1 dan t_2 dengan x sebagai masukan, keadaan yang telah diperbarui cukup menjadi s_2 = {x, t_1, t_2}. Keadaan kita dimulai dengan prompt x dan diperbarui dengan menggabungkan setiap token baru yang dihasilkan LLM ke keadaan tersebut.
Formulasi Markov Decision Process (MDP)
Formulasi MDP. Untuk LLM, ada dua cara utama merumuskan RL yang berbeda dalam cara keduanya memodelkan tindakan. Seperti disebutkan di atas, kita dapat memodelkan setiap token dalam proses next-token prediction sebagai tindakan tersendiri. Pendekatan ini disebut formulasi Markov Decision Process (MDP). MDP pada dasarnya merupakan kerangka probabilistik untuk memodelkan pengambilan keputusan yang mencakup keadaan, tindakan, probabilitas transisi, dan reward—persis kerangka yang telah kita bahas sejauh ini untuk RL! Formulasi MDP yang digunakan dalam RL diperlihatkan pada ilustrasi di artikel asli.
Ketika memodelkan RL dengan LLM sebagai MDP, keadaan awal kita adalah prompt, dan policy kita bertindak dengan memprediksi token-token secara individual. LLM kita merupakan policy stokastik yang memprediksi distribusi probabilitas atas token-token. Selama proses generasi, pada setiap langkah suatu tindakan dilakukan dengan memilih sebuah token dari distribusi tersebut. Setelah sebuah token diprediksi, token itu ditambahkan ke keadaan dan digunakan oleh LLM untuk memprediksi tindakan atau token berikutnya! Pada akhirnya, LLM memprediksi token penghenti (misalnya, <|end_of_text|> atau <eos>) untuk menyelesaikan proses generasi, sehingga menghasilkan sebuah trajectory lengkap.
Tingkat Pemberian Reward
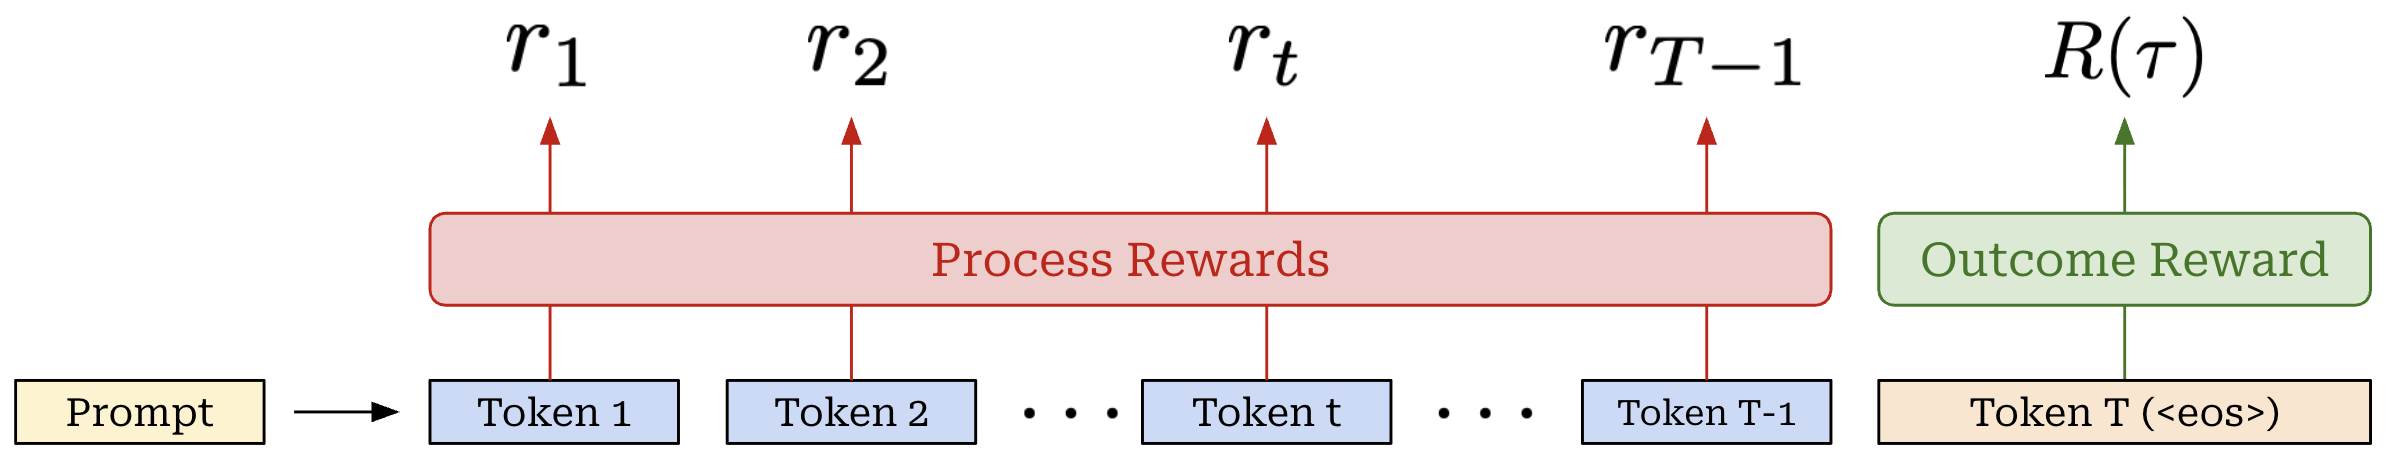
Granularitas reward. Sejauh ini, perumusan-perumusan kita menggambarkan reward r_t yang diberikan pada setiap langkah proses generasi4. Namun, ketika melatih LLM menggunakan RL, ada dua tingkat pemberian reward yang biasanya digunakan untuk completion yang dihasilkan LLM:
- Outcome reward diberikan kepada keseluruhan completion.
- Process reward diberikan pada langkah-langkah perantara di dalam completion.
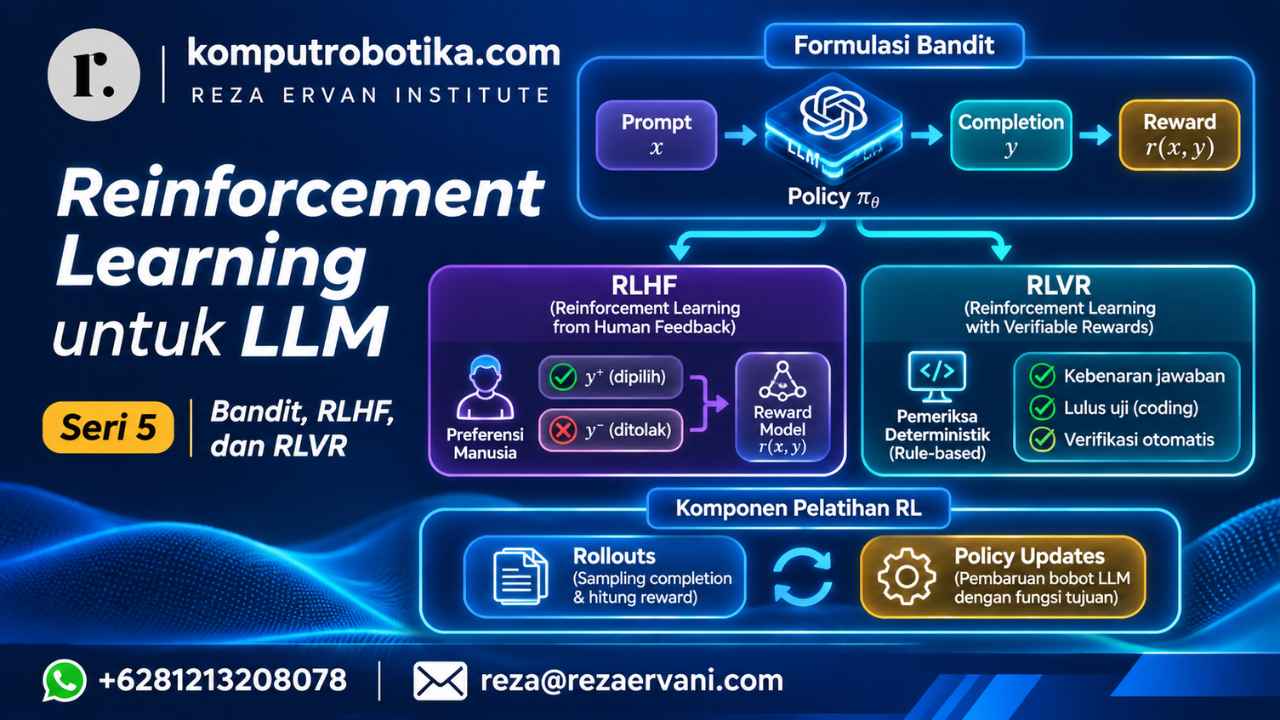
Kedua jenis reward tersebut digambarkan di bawah ini. Outcome reward paling umum digunakan dalam pengaturan pelatihan LLM belakangan ini karena kita dapat memberikan reward berdasarkan kebenaran sebuah completion. Namun, outcome reward bersifat jarang atau sparse—reward itu memberi tahu kita apakah keseluruhan completion baik atau buruk—yang dapat menyulitkan pembelajaran. Sebaliknya, process reward dapat meningkatkan efisiensi pembelajaran dengan memungkinkan credit assignment yang lebih terperinci pada sejumlah tahap perantara dalam keseluruhan completion.
Catatan Kaki Penulis
4 Perhatikan bahwa sebagian reward yang diberikan tersebut dapat bernilai nol. Oleh karena itu, kita masih dapat merumuskan pengaturan outcome reward dengan memberikan reward nol pada setiap langkah, kemudian memberikan outcome reward pada langkah terakhir.
Sumber asli: Cameron R. Wolfe, Ph.D., Reinforcement Learning for LLMs: The Complete Guide, 24 Agustus 2026. Terjemahan Bahasa Indonesia untuk FLOWER — komputrobotika.com.
Bersambung ke bagian berikutnya, in sya Allah