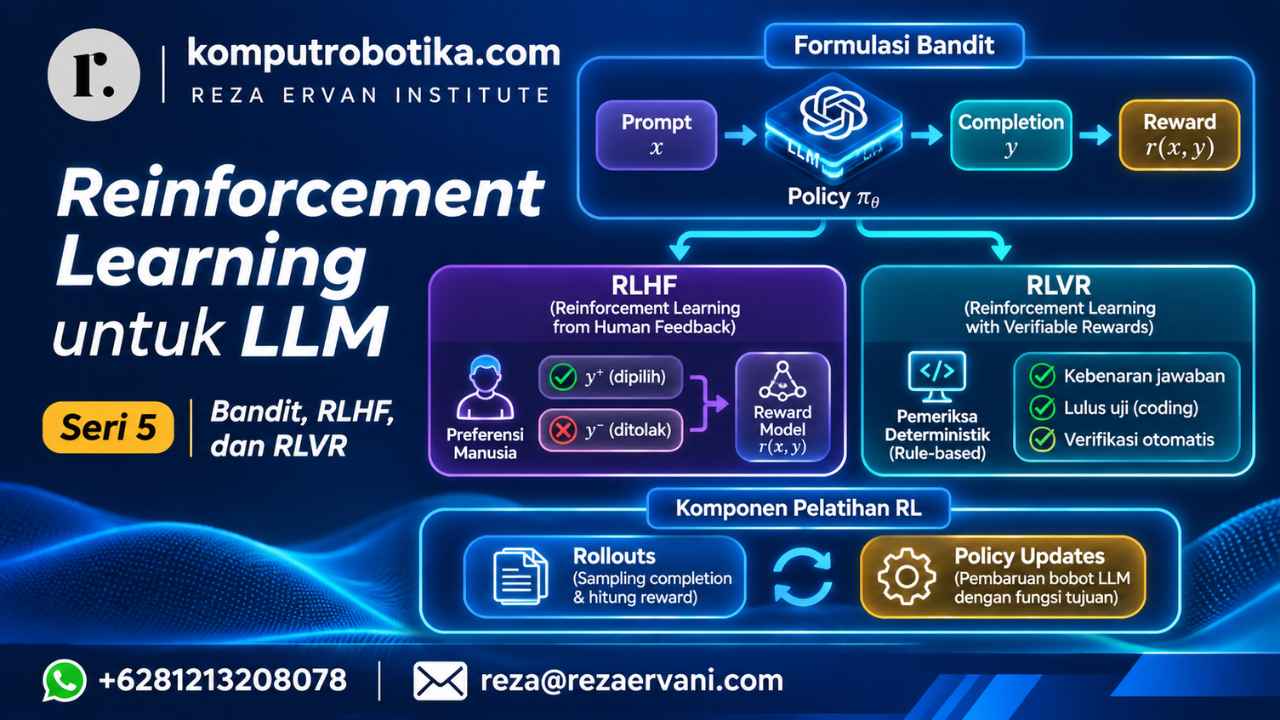
Formulasi Bandit
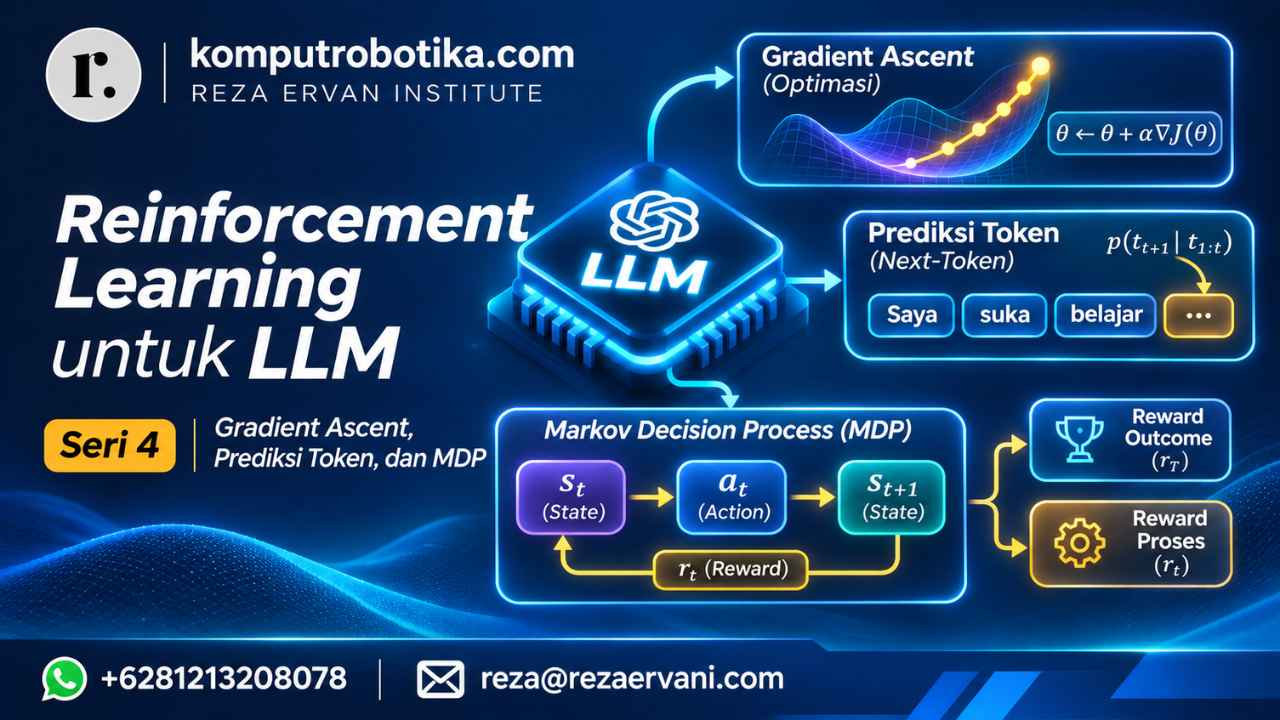
Formulasi bandit. Mengingat outcome reward merupakan pengaturan yang umum untuk RL pada LLM, kita mungkin bertanya-tanya: apakah memang masuk akal untuk memodelkan setiap token sebagai tindakan tersendiri? Reward baru diberikan setelah LLM menghasilkan respons lengkap, yang berarti tidak ada reward yang diberikan pada tingkat token. Sebagai gantinya, kita dapat memodelkan seluruh respons sebagai satu tindakan yang menerima outcome reward. Inilah gagasan utama di balik formulasi bandit untuk pelatihan RL; lihat di bawah ini.
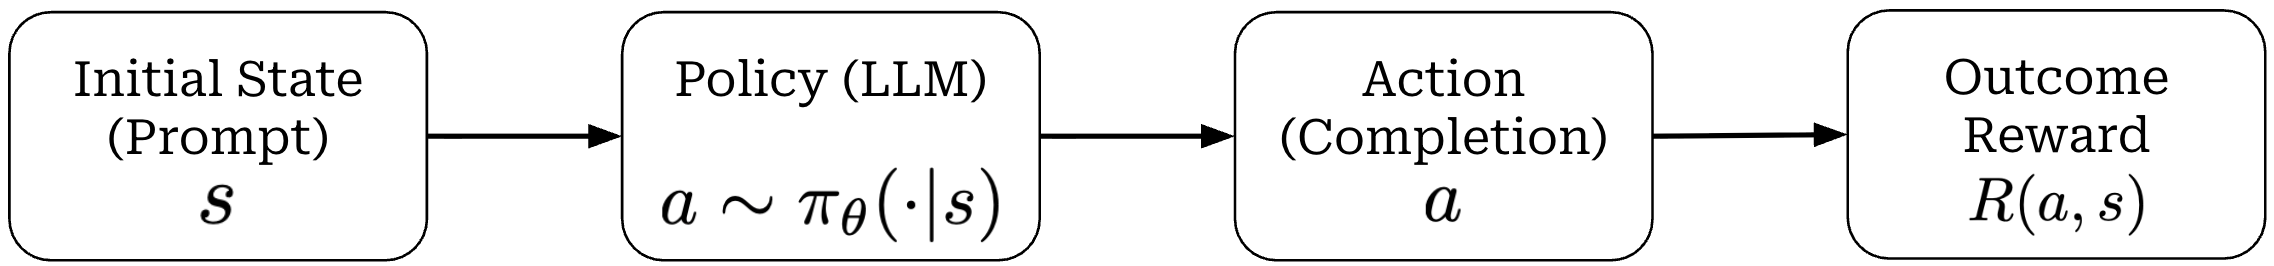
Nama ini berasal dari gagasan contextual bandit dalam teori probabilitas. Pengaturan bandit sederhana: agen kita memilih suatu tindakan, menerima reward, lalu episode berakhir. Keseluruhan trajectory kita hanya terdiri dari satu tindakan dan satu reward! Untuk LLM, tindakan kita adalah keseluruhan completion yang dihasilkan berdasarkan sebuah prompt, dan completion tersebut menerima outcome reward. Dalam formulasi bandit, notasi x dan y juga lazim digunakan, masing-masing untuk prompt dan respons (yakni, sebagai pengganti s dan a pada gambar di atas).
“Mengingat bahwa dalam penerapan LLM,
r(x, y)baru diperoleh pada akhir keseluruhan urutan, mungkin lebih tepat untuk memodelkan seluruh proses generasi sebagai satu tindakan, bukan setiap token sebagai tindakan tersendiri.” — dari [15]
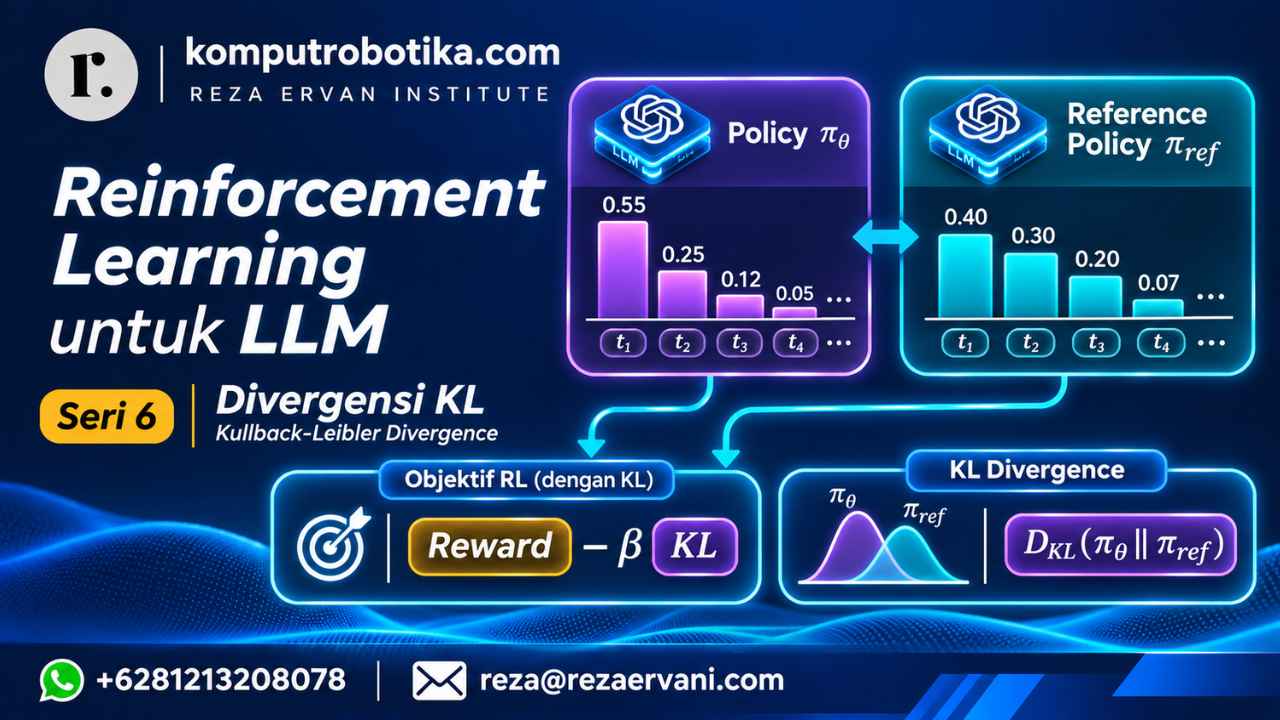
Dalam konteks LLM, kita sudah mengetahui cara menghitung probabilitas token secara individual maupun probabilitas keseluruhan completion untuk suatu prompt. Oleh karena itu, kita memiliki kemampuan untuk memodelkan RL menggunakan formulasi MDP ataupun bandit. Sebagaimana akan kita pelajari, kedua formulasi tersebut umum digunakan dalam praktik. Sebagai contoh, REINFORCE dan RLOO lazim dirumuskan menggunakan formulasi bandit, sedangkan algoritma seperti PPO biasanya dirumuskan sebagai MDP. Kedua formulasi tersebut sama-sama valid, dan kita akan melihat sejumlah contoh penerapan formulasi bandit dan MDP sepanjang tinjauan ini.
Menghitung Reward
Menghitung reward. Masih ada satu pertanyaan terakhir yang belum kita jawab: bagaimana kita memperoleh reward selama pelatihan LLM? Jawabannya bergantung pada jenis pelatihan RL yang digunakan. Saat ini, ada dua kategori besar pelatihan yang digunakan:
- Reinforcement Learning from Human Feedback (RLHF) melatih LLM menggunakan RL dengan reward yang diperoleh dari model reward berdasarkan preferensi manusia.
- Reinforcement Learning with Verifiable Rewards (RLVR) melatih LLM menggunakan RL dengan reward yang diperoleh dari pemeriksa berbasis aturan atau pemeriksa deterministik.
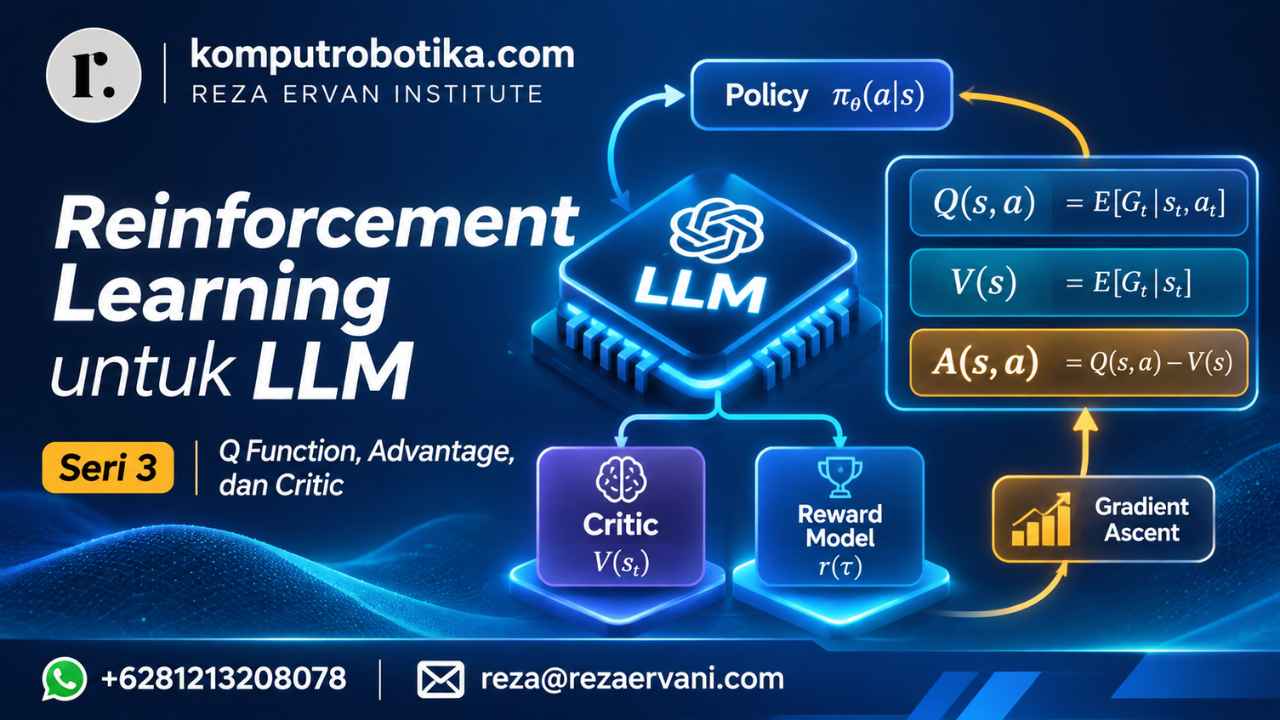
Kedua kerangka tersebut digambarkan pada ilustrasi perbandingan dalam artikel asli. Dalam RLHF, kita mengumpulkan sejumlah besar data preferensi—yang terdiri atas sebuah prompt beserta completion yang dipilih (chosen) dan yang ditolak (rejected)—untuk melatih reward model, yaitu LLM yang ditambahi regression head dan dilatih agar menghasilkan skor preferensi ketika menerima prompt dan completion sebagai masukan. Reward dihitung secara langsung menggunakan reward model ini selama pelatihan dengan RLHF.
Sebaliknya, RLVR memperoleh reward dengan memeriksa kebenaran suatu completion menggunakan fungsi verifikasi deterministik. Sebagai contoh, kita dapat memeriksa apakah jawaban LLM terhadap soal matematika benar dengan mengekstraksi jawaban yang dihasilkan, lalu melakukan pencocokan string secara persis (exact string matching)—atau menggunakan pendekatan pencocokan simbolik—terhadap jawaban acuan (ground truth). Demikian pula, kita dapat memverifikasi tugas pemrograman dengan menjalankan serangkaian kasus pengujian yang telah diketahui dan memeriksa apakah kode yang dihasilkan LLM lolos seluruh pengujian tersebut.
“Kami tidak menggunakan neural reward model dalam pengembangan DeepSeek-R1-Zero karena kami mendapati bahwa neural reward model dapat mengalami reward hacking dalam proses RL berskala besar. Melatih ulang reward model juga membutuhkan sumber daya pelatihan tambahan dan memperumit keseluruhan alur pelatihan.” — dari [9]
Karena RLVR memperoleh reward dari fungsi deterministik, bukan dari reward model, risiko reward hacking selama pelatihan jauh lebih rendah. Karena alasan ini, reward yang dapat diverifikasi memungkinkan pelatihan RL yang stabil pada skala yang sangat besar, yang telah menghasilkan kemajuan signifikan dalam kemampuan model penalaran (reasoning models) dan agen.
Komponen Pelatihan RL
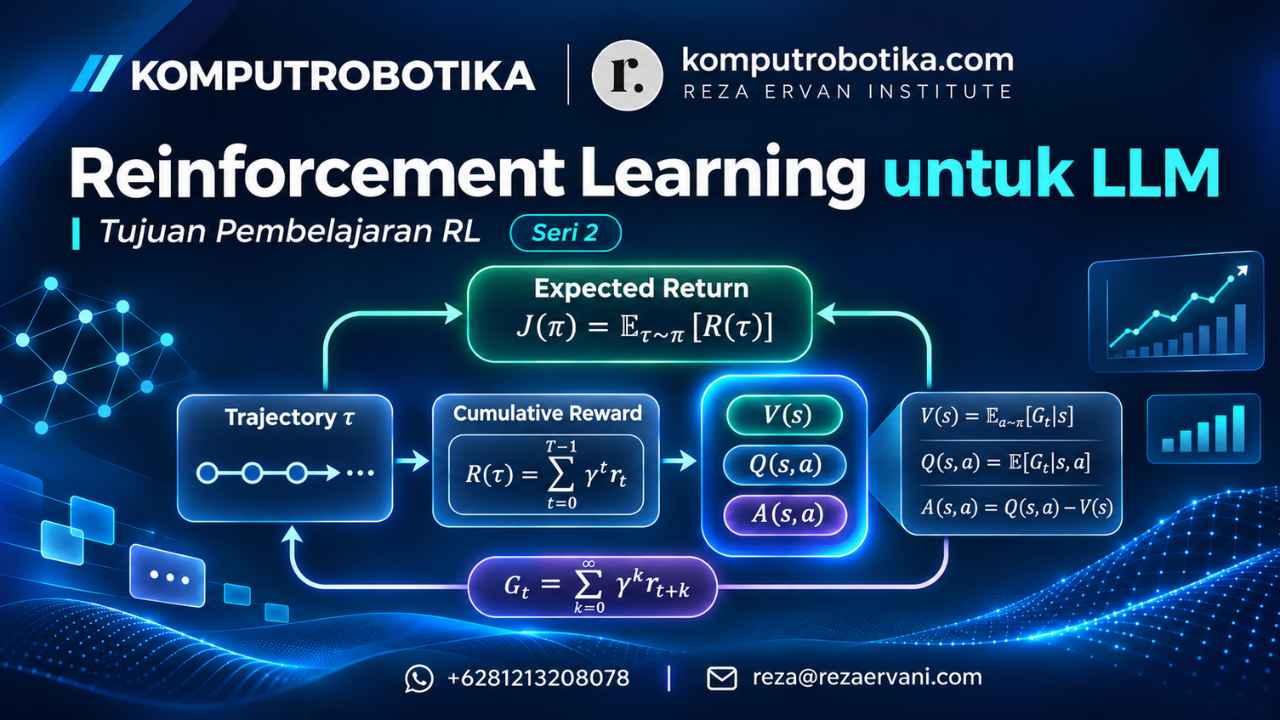
Komponen-komponen pelatihan RL. Kita akan melihat banyak variasi pelatihan RL dalam tinjauan ini, tetapi semuanya mengikuti struktur umum tingkat tinggi yang serupa; lihat ilustrasi pada artikel asli. Secara khusus, proses pelatihan RL bergantian antara dua langkah utama:
- Rollouts: dengan sekumpulan prompt, ambil sampel completion untuk setiap prompt menggunakan LLM saat ini (dan hitung reward untuk setiap completion).
- Policy updates: hitung pembaruan bobot untuk LLM menggunakan rollout yang telah diambil sebagai sampel dan fungsi tujuan yang ditetapkan.
Struktur pembaruan policy bergantung pada pengoptimal RL (RL optimizer) yang digunakan. Bahkan, sebagian besar tinjauan ini akan berfokus pada penguraian berbagai algoritma dan metode yang digunakan untuk menangani pembaruan policy tersebut!
Sumber asli: Cameron R. Wolfe, Ph.D., Reinforcement Learning for LLMs: The Complete Guide, 24 Agustus 2026. Terjemahan Bahasa Indonesia untuk FLOWER — komputrobotika.com.
Bersambung ke bagian berikutnya, in sya Allah