Tujuan Pembelajaran dalam RL
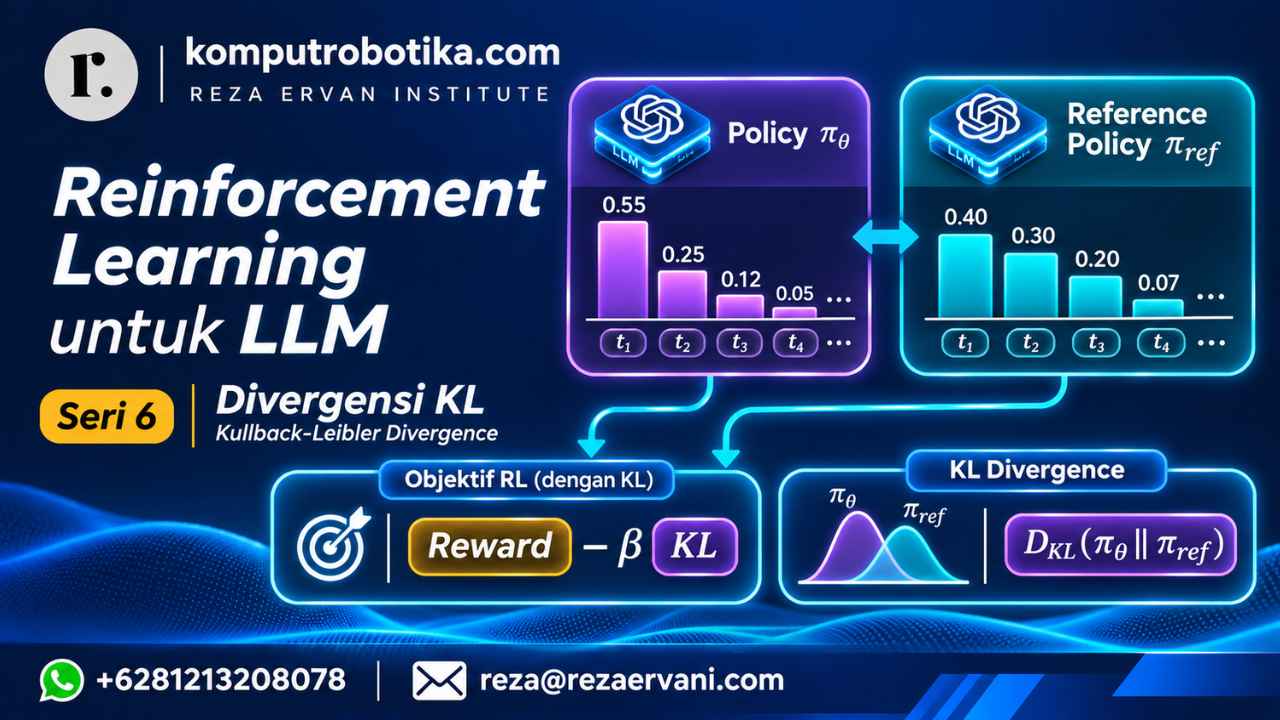
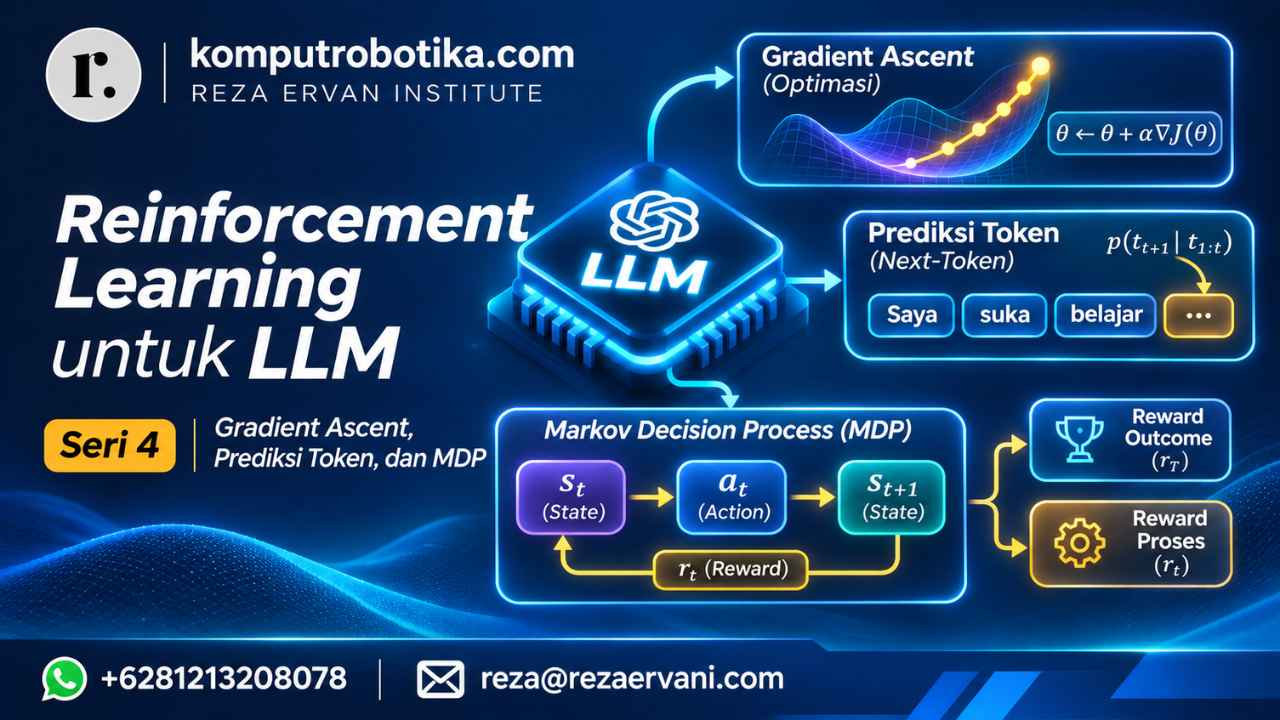
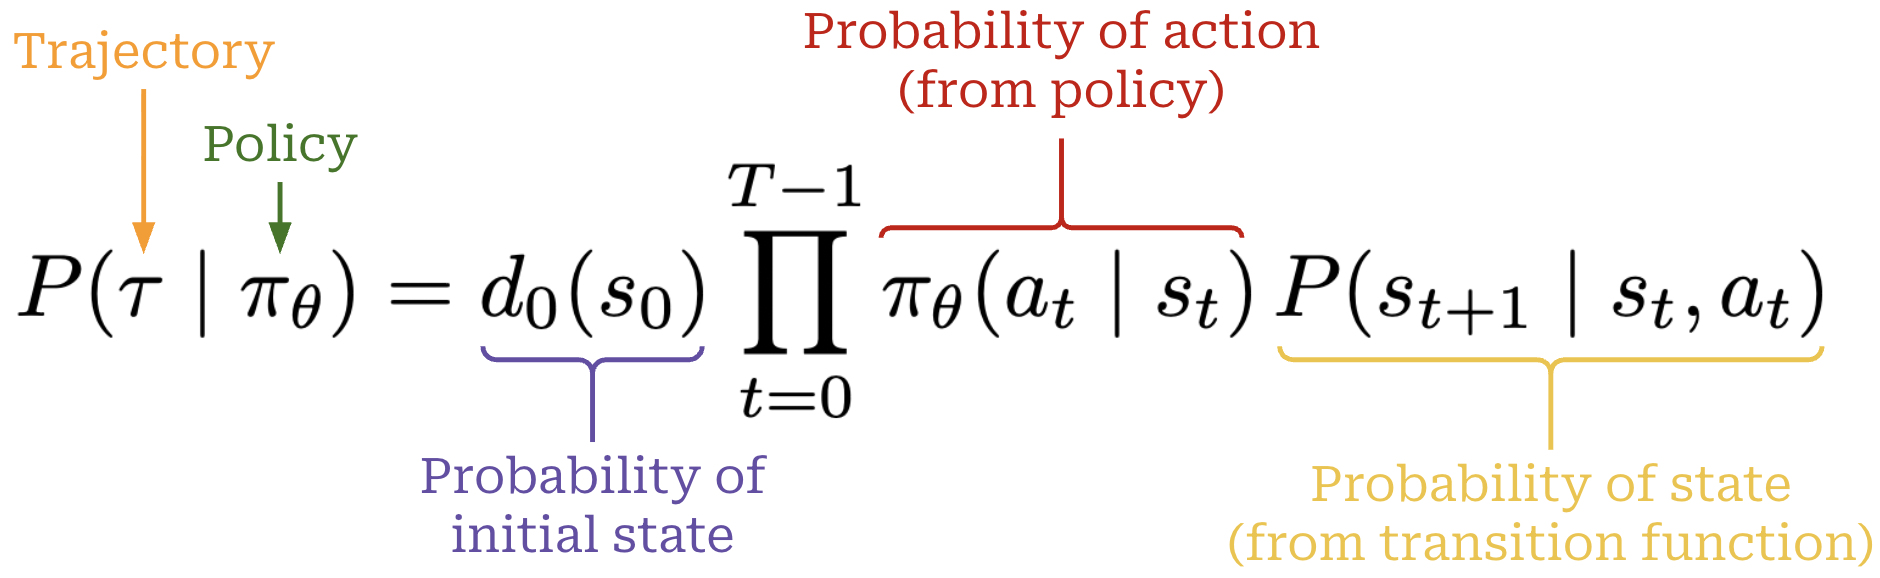
Seperti yang telah dibahas sebelumnya, setiap langkah dalam suatu trajectory diambil sebagai sampel berdasarkan dua distribusi probabilitas:
- Distribusi tindakan
π_θ(a_t | s_t)yang diprediksi oleh policy kita berdasarkan keadaan saat ini pada waktut. - Distribusi keadaan berikutnya
P(s_(t+1) | a_t, s_t)yang diberikan oleh fungsi transisi kita untuk keadaan saat inis_tdan tindakana_tyang diambil sebagai sampel pada waktut.
Dengan menggunakan aturan rantai probabilitas (chain rule of probabilities), kita dapat menggunakan kedua distribusi ini untuk menghitung probabilitas sebuah trajectory secara keseluruhan, sebagaimana ditunjukkan di bawah ini.
Imbalan kumulatif (cumulative reward) dari suatu trajectory hanyalah jumlah nilai r_t untuk seluruh langkah waktu t dalam trajectory tersebut. Imbalan kumulatif juga lazim disebut return dari suatu trajectory. Ada dua cara umum untuk menyatakan return: dengan diskonto (discounted) atau tanpa diskonto (non-discounted); lihat di bawah ini. Return dengan diskonto memasukkan faktor diskonto γ ∈ [0, 1], yang dipangkatkan dengan t, ke dalam penjumlahan seluruh imbalan. Dalam praktiknya, faktor diskonto menurunkan nilai imbalan di masa depan secara eksponensial sehingga mendorong model memperoleh imbalan lebih cepat, bukan lebih lambat.1
Biasanya, return tanpa diskonto dinyatakan menggunakan finite horizon, yang berarti panjang total trajectory T terbatas. Sebaliknya, return dengan diskonto umumnya dinyatakan menggunakan infinite horizon (yaitu T = ∞), sebagaimana ditunjukkan di atas. Untuk post-training LLM, kita sering memiliki T yang terbatas dan γ = 1 karena pada umumnya kita menggunakan imbalan yang diperoleh pada tingkat trajectory (atau completion), bukan pada setiap keadaan. Namun, sebagaimana akan kita lihat sepanjang tinjauan ini, hal tersebut tidak selalu berlaku. Sebagai contoh, penalti KL sering dirumuskan sebagai imbalan per token, dan GAE menggunakan faktor diskonto ketika memperkirakan advantage.
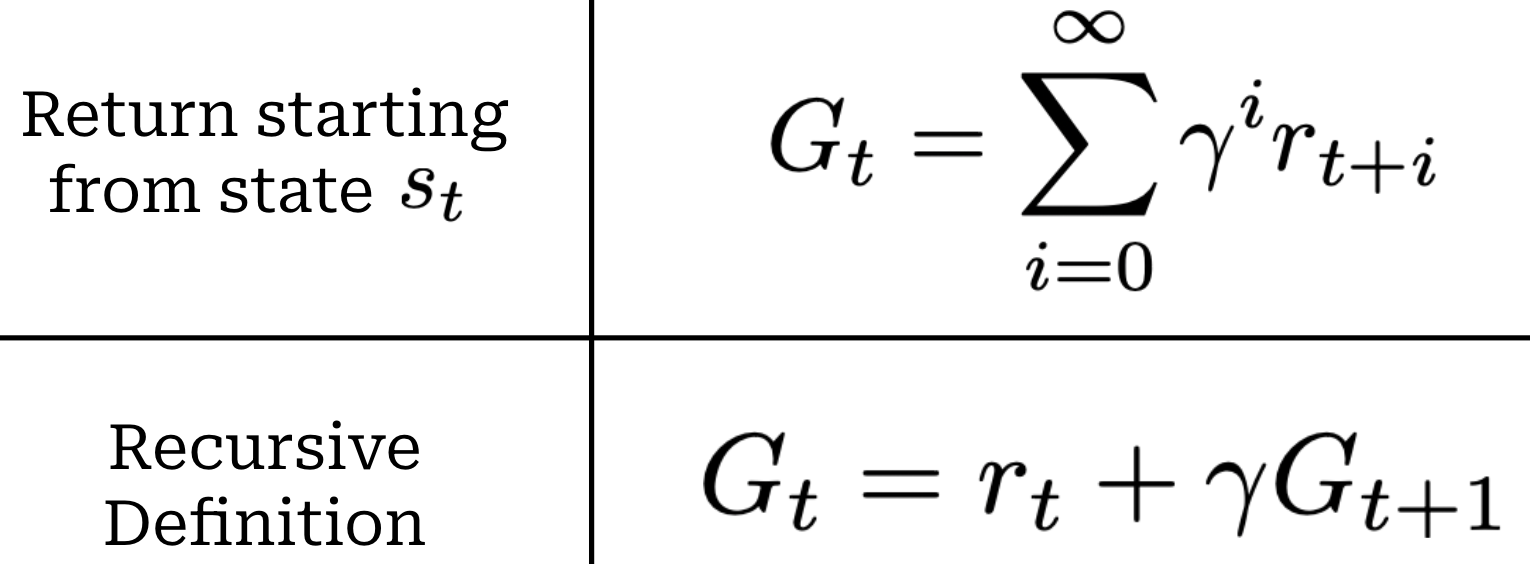
Alih-alih menyatakan return untuk keseluruhan trajectory sebagai R(τ), kita juga dapat merumuskan return G_t yang dimulai dari keadaan s_t; lihat di atas. Notasi semacam ini umum digunakan dalam literatur2 dan juga memungkinkan kita menyatakan return secara rekursif.
Fungsi tujuan (objective function) dalam RL adalah memaksimalkan expected return dari policy saat ini. Kita dapat langsung menyatakan tujuan tersebut sebagai nilai harapan (expectation) atas trajectory yang diambil sebagai sampel, yang dapat ditulis sebagai integral ataupun penjumlahan diskret berbobot probabilitas atas berbagai trajectory yang mungkin; lihat di bawah ini.
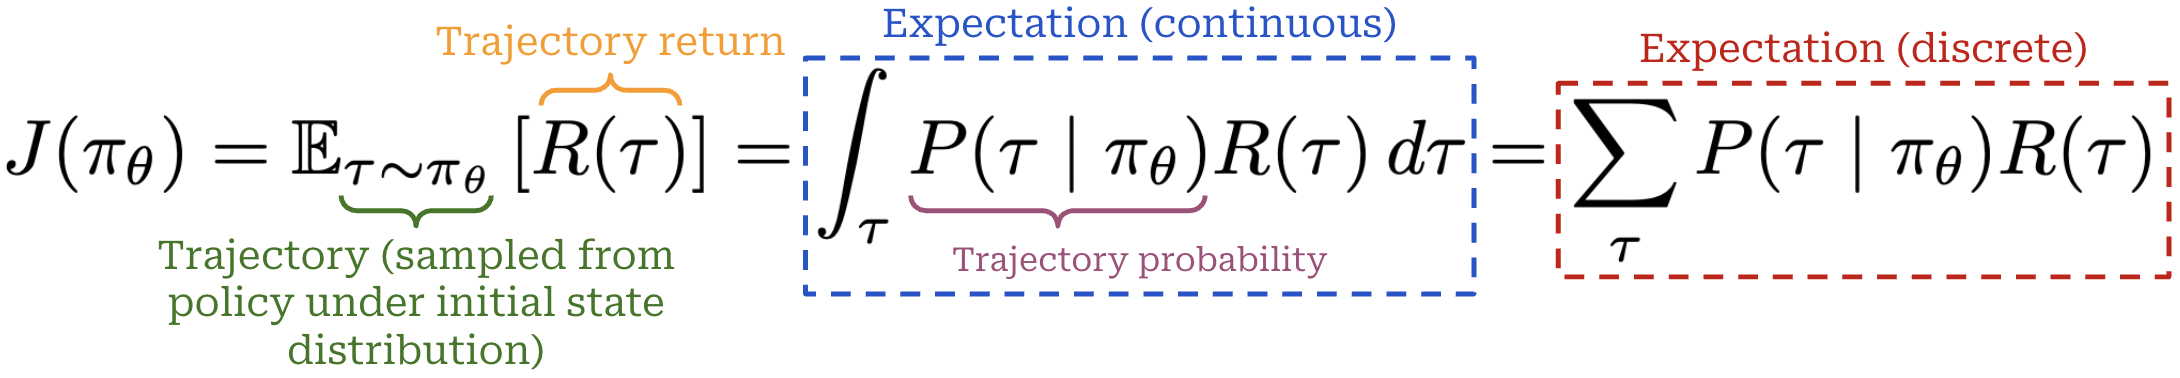
Dalam praktiknya, menghitung expected return sebagai penjumlahan diskret atas seluruh trajectory yang mungkin tidaklah memungkinkan (yakni, ada terlalu banyak trajectory yang mungkin untuk didaftarkan secara eksplisit). Sebagai gantinya, kita membuat estimasi Monte Carlo3 terhadap tujuan tersebut dengan menggunakan return dari trajectory yang diambil sebagai sampel secara acak; lihat di bawah ini.
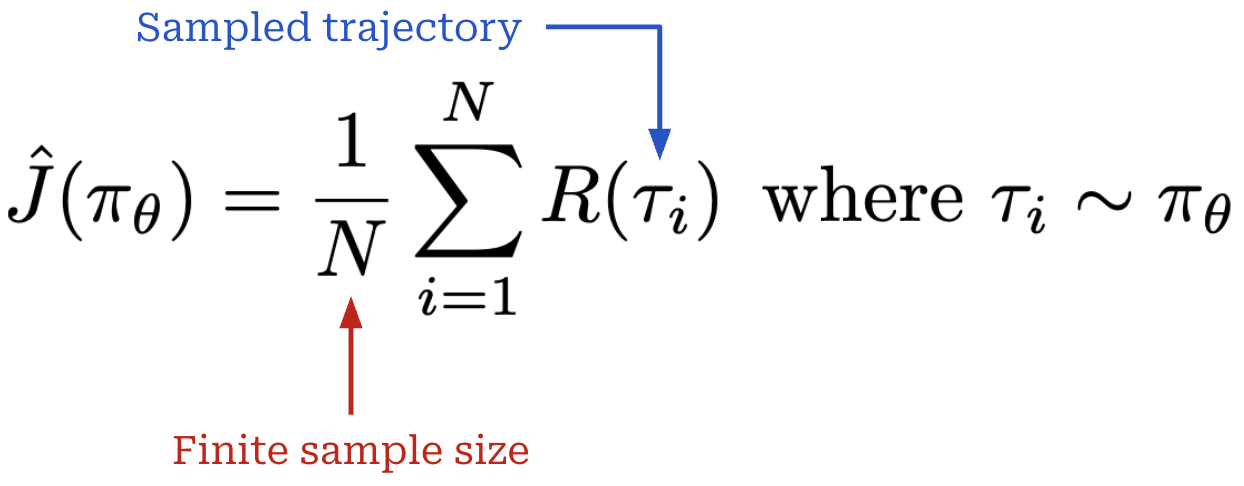
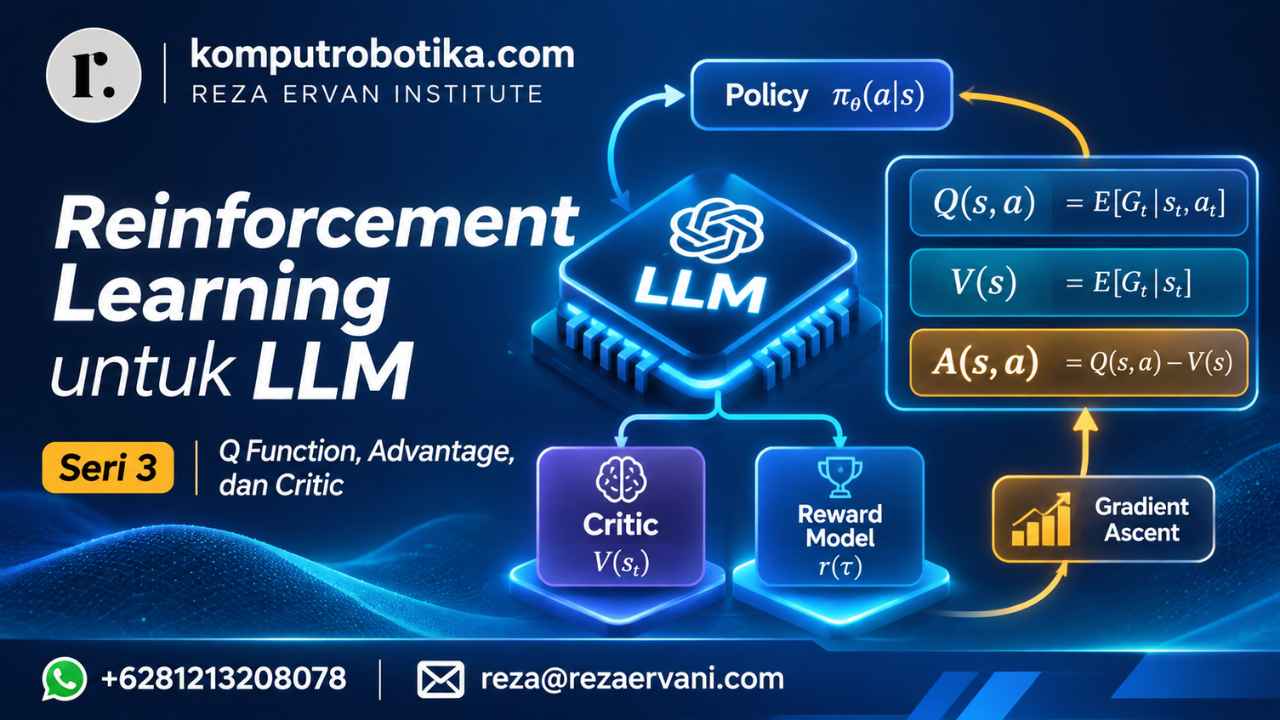
Fungsi value dan advantage. Tujuan RL memperhitungkan imbalan kumulatif yang diharapkan dari suatu policy. Berkaitan dengan tujuan ini, terdapat sejumlah fungsi berikut (ditunjukkan di bawah ini) yang lazim dirujuk dalam RL:
- Value Function
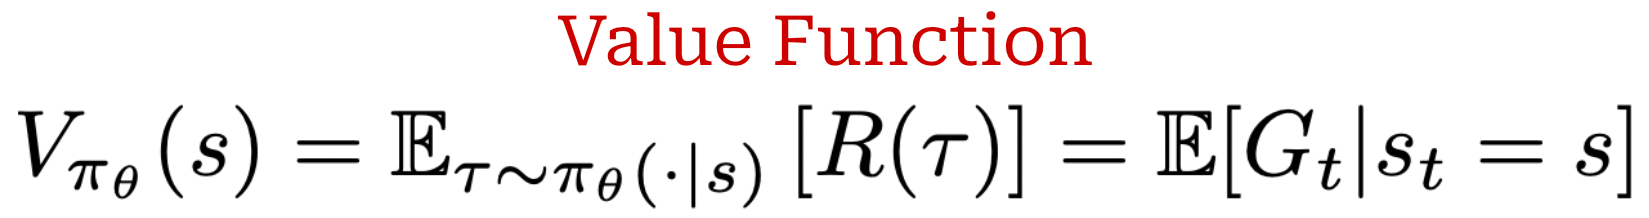
V(s): imbalan kumulatif yang diharapkan ketika Anda memulai dari keadaansdan bertindak sesuai dengan policy Anda saat ini,π_θ. - Action-Value / Q Function
Q(s, a): imbalan kumulatif yang diharapkan ketika Anda memulai dari keadaans, melakukan tindakana, kemudian bertindak sesuai dengan policy Anda,π_θ. - Advantage Function
A(s, a): selisih antara fungsi action-value dan fungsi value; yakniA(s, a) = Q(s, a) - V(s).
Fungsi value V(s) berkaitan erat dengan tujuan kita dalam RL. Fungsi value juga memperhitungkan expected return, tetapi—berbeda dengan tujuan RL—fungsi ini mengondisikan nilai harapan tersebut pada keadaan saat ini s; lihat di bawah ini. Sebaliknya, tujuan RL mengambil nilai harapan atas seluruh trajectory yang dapat dihasilkan oleh policy saat ini berdasarkan distribusi keadaan awal tertentu.
Catatan Kaki Penulis
- Diskonto adalah konsep umum yang muncul di banyak bidang di luar AI; lihat rujukan yang ditautkan pada catatan kaki artikel asli untuk keterangan lebih lanjut.
- Perlu dicatat bahwa notasi ini digunakan dalam The RLHF Book, serta tulisan populer lain mengenai algoritma policy gradient. Namun,
R(τ)juga lazim digunakan; misalnya, dalam seri Spinning Up in Deep RL dari OpenAI. - Sederhananya, estimasi Monte Carlo hanyalah istilah yang lebih rumit untuk menyatakan bahwa kita mengambil sampel secara acak dan menghitung rata-ratanya guna memperkirakan suatu nilai sasaran (misalnya, nilai harapan).
Sumber asli: Cameron R. Wolfe, Ph.D., Reinforcement Learning for LLMs: The Complete Guide, 24 Agustus 2026. Terjemahan Bahasa Indonesia untuk FLOWER — komputrobotika.com.
Bersambung ke bagian berikutnya, in sya Allah