Menelusuri evolusi reinforcement learning, mulai dari prinsip-prinsip pertama hingga garis terdepan penelitian kecerdasan buatan modern.
Reinforcement learning (RL), atau pembelajaran penguatan, telah memainkan peran yang sangat penting sepanjang sejarah penelitian large language models (LLM). Melalui RL, kita mengembangkan versi-versi awal model yang mampu mengikuti instruksi, mencapai kemajuan penting dalam penyelarasan (alignment) dan keselamatan, serta memungkinkan LLM menyelesaikan persoalan penalaran yang kompleks. Namun, terlepas dari banyaknya terobosan tersebut, RL tetap menjadi salah satu bidang yang berkembang paling pesat dalam penelitian kecerdasan buatan. Banyak persoalan paling mendesak yang berusaha kita selesaikan saat ini—penalaran, pekerjaan berbasis pengetahuan, agen, efisiensi token, keandalan, dan banyak lagi—sedang ditangani melalui RL. Dalam tinjauan ini, kita akan bergerak menuju garis terdepan penelitian RL dengan memulai dari prinsip-prinsip pertama. Dalam satu tinjauan, kita akan membahas dasar-dasar RL, seluruh perkembangan algoritma policy gradient yang sekarang digunakan untuk melatih LLM, serta sejumlah bidang penelitian baru yang belakangan muncul dalam RL.
Bergabunglah dengan banyak pembaca lain yang menggunakan Deep (Learning) Focus untuk memahami penelitian AI. Pertimbangkan berlangganan versi berbayar apabila Anda ingin membantu mendukung buletin ini.
Bacaan Terkait
Tinjauan ini dimaksudkan sebagai referensi mandiri yang dapat digunakan untuk mempelajari konsep-konsep mendasar dalam penelitian RL. Namun, sebagian besar isinya merupakan sintesis dari berbagai sumber dan tulisan blog—baik dari luar maupun tulisan saya sendiri—yang telah diterbitkan selama bertahun-tahun. Informasi penting akan disajikan pada setiap bagian tinjauan ini. Sebagian besar bagian akan diakhiri dengan tautan menuju tulisan yang mengulas topik tersebut secara lebih mendalam, termasuk rincian lanjutan dan penelitiannya. Di samping tulisan-tulisan tambahan yang ditautkan pada masing-masing bagian, sejumlah sumber eksternal berikut sangat membantu dalam penyusunan referensi ini:
- The RLHF Book, karya Nathan Lambert.
- Reinforcement Learning, karya Richard S. Sutton dan Andrew G. Barto.
- Spinning Up in Deep RL, dari OpenAI.
- Build an LLM / Reasoning Model from Scratch, karya Sebastian Raschka.
- Berbagai catatan dan makalah karya John Schulman.
- Policy Gradient Algorithms, karya Lilian Weng.
- A Vision Researcher’s Guide to RL, karya Yuge (Jimmy) Shi.
- From REINFORCE to Dr. GRPO, karya Qingfeng Lan.
- Async GRPO in the Wild, karya Yumo Xu.
- Infrastruktur RL terbuka seperti TRL dan OpenInstruct.
Dasar-Dasar RL untuk LLM
Untuk memahami RL bagi LLM, kita harus memulai dengan membangun pengetahuan latar belakang yang diperlukan mengenai konsep-konsep umum dalam RL. Bagian ini akan berfokus pada penjelasan konsep-konsep mendasar yang menjadi landasan berbagai algoritma RL yang akan kita jumpai nanti dalam tulisan ini. Secara khusus, kita akan menyajikan kerangka formal untuk RL, sekaligus menguraikan tujuan pembelajaran yang digunakan dalam pelatihannya. Setelah itu, kita akan mengembangkan gagasan-gagasan tersebut dengan membahas bagaimana RL dirumuskan dalam konteks pelatihan LLM.
Kerangka Umum untuk RL
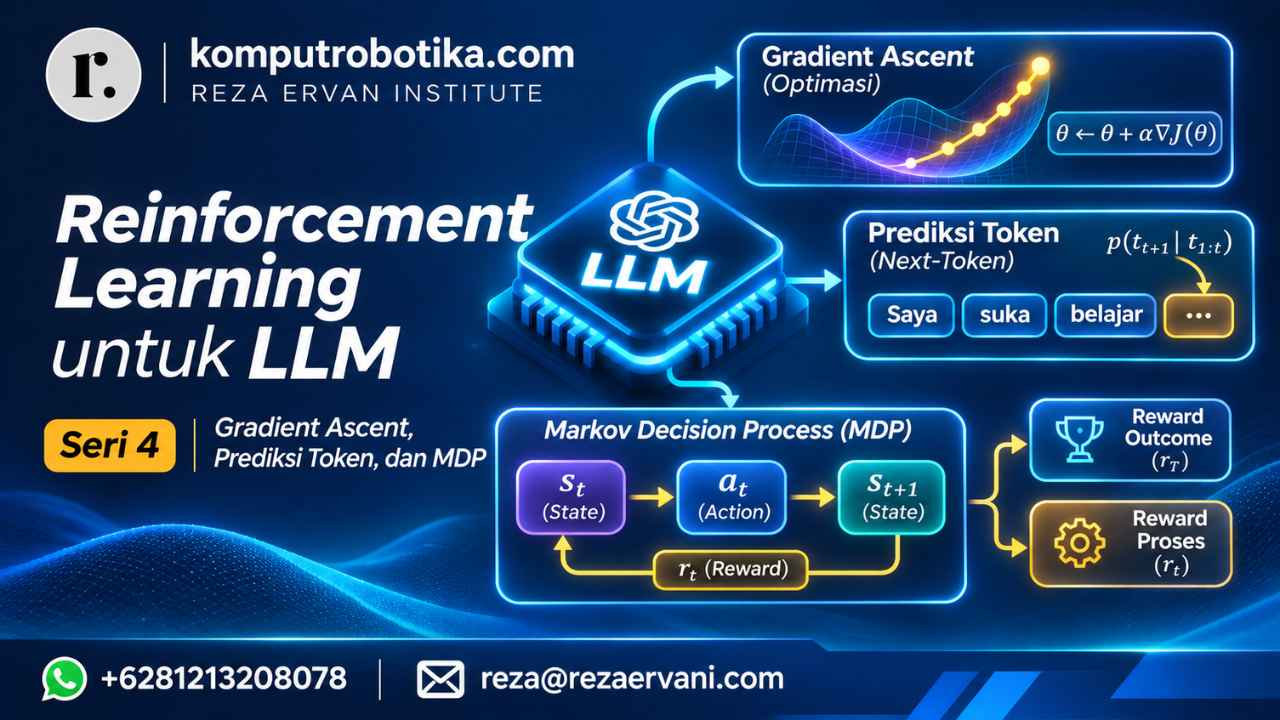
Ketika menjalankan pelatihan RL, kita memiliki sebuah agent (agen) yang secara berulang melakukan tindakan di dalam suatu environment (lingkungan); lihat gambar di bawah ini. Setiap langkah dalam proses berulang tersebut dinyatakan dengan suatu langkah waktu t, sedangkan tindakan pada waktu t kita nyatakan sebagai a_t.
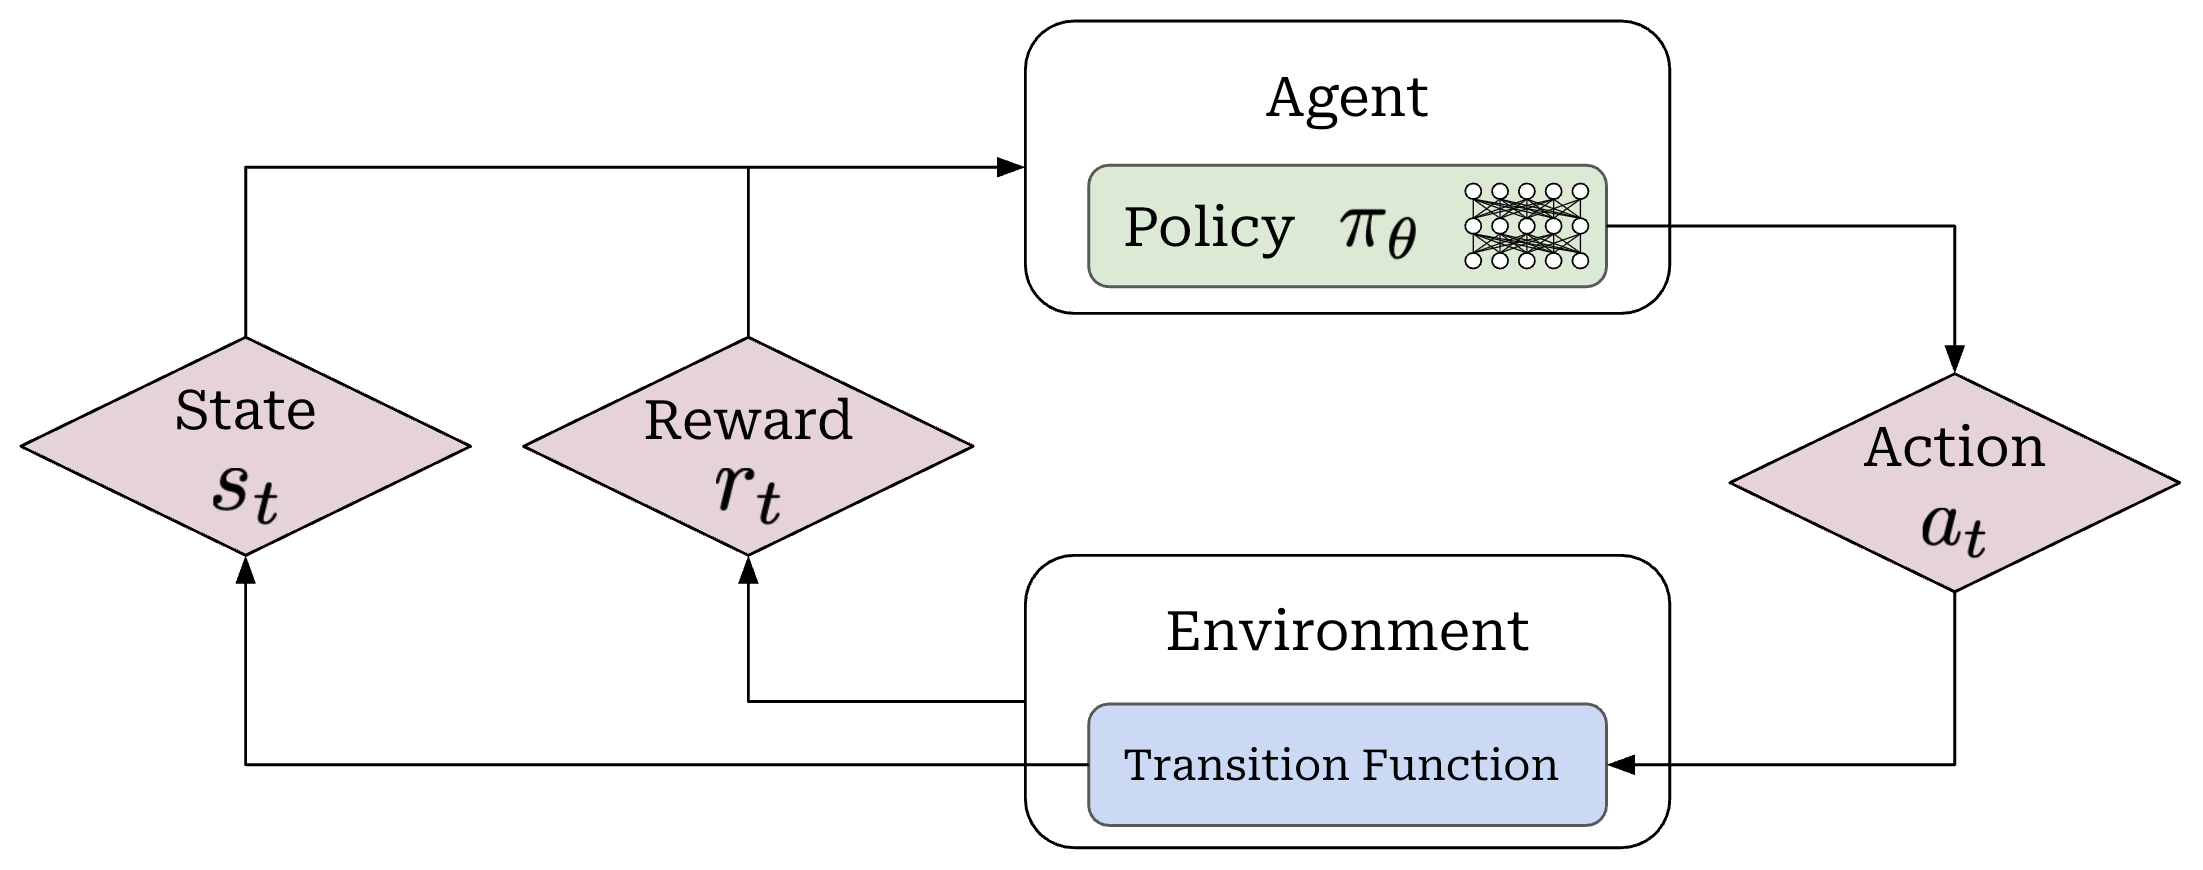
Tindakan-tindakan tersebut diprediksi oleh sebuah policy (kebijakan)—yang dapat kita bayangkan sebagai otak agen—dengan parameter θ (misalnya, dalam konteks pelatihan LLM, policy itu adalah LLM itu sendiri). Policy kita dapat bersifat deterministik ataupun stokastik, tetapi untuk LLM kita akan mengasumsikan bahwa policy bersifat stokastik. Policy stokastik kita, π_θ, menghasilkan distribusi probabilitas atas himpunan tindakan yang mungkin, lalu sebuah tindakan a_t diambil sebagai sampel dari distribusi tersebut. Probabilitas suatu tindakan kita nyatakan sebagai π_θ(a_t | s_t).
Ketika policy menghasilkan suatu tindakan, keadaan lingkungan akan diperbarui sesuai dengan transition function (fungsi transisi), yang merupakan bagian dari lingkungan. Keadaan pada waktu t dinyatakan sebagai s_t. Fungsi transisi kita dituliskan sebagai P(s_(t+1) | a_t, s_t). Namun, kita akan segera melihat bahwa fungsi transisi tidak begitu relevan dalam konteks LLM, meskipun fungsi tersebut tetap berperan dalam pengaturan tertentu (misalnya, pada agen).
Setelah suatu tindakan dilakukan, lingkungan memberikan reward (imbalan), yang menggambarkan seberapa diinginkannya suatu keadaan atau tindakan. Reward dapat bernilai positif, negatif, ataupun nol, dan reward yang diberikan pada langkah waktu t biasanya dinyatakan sebagai r_t. Secara intuitif, kita dapat memahami RL sebagai proses mencoba dan melakukan kesalahan (trial and error). Ketika agen bertindak di dalam lingkungannya, proses pelatihan memperkuat perilaku yang diamati—baik secara positif maupun negatif—melalui reward. Dari sinilah muncul istilah pembelajaran “penguatan” (reinforcement).
Dimulai dari keadaan awal s_0 yang diambil sebagai sampel dari distribusi d_0 atas himpunan keadaan awal, agen akan berulang kali:
- Mengambil sampel tindakan (
a_t). - Berpindah ke keadaan baru (
s_(t+1)). - Menerima reward (
r_t).
Proses ini akan terus berlangsung sampai keadaan akhir s_T tercapai—baik karena keadaan tersebut merupakan keadaan terminal maupun karena jumlah langkah maksimum yang telah ditentukan sebelumnya sudah tercapai. Secara bersama-sama, urutan langkah dalam proses ini membentuk suatu trajectory (lintasan); lihat gambar di bawah ini.
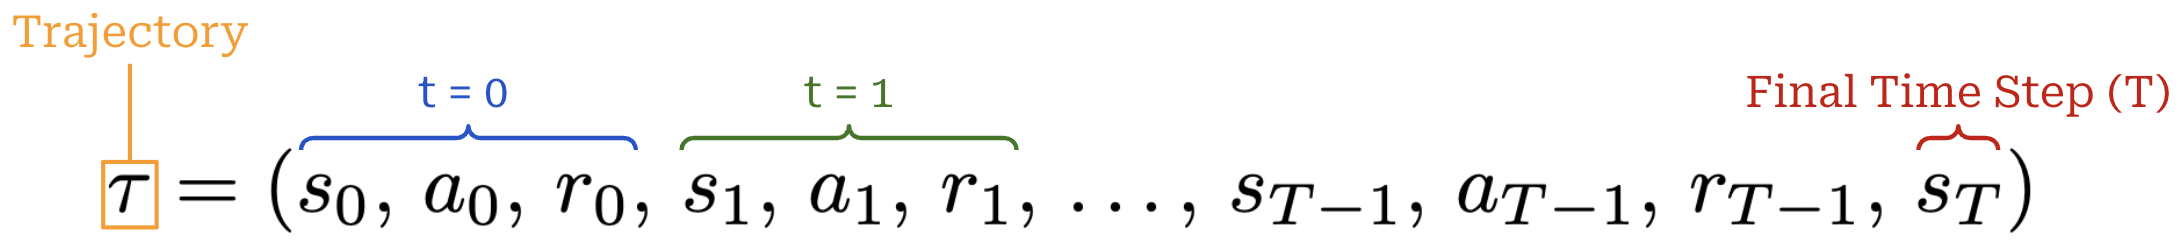
Proses pelatihan RL berulang kali mengambil sampel trajectory dari agen dengan cara ini. Melalui proses tersebut, agen mendapat kesempatan untuk mengeksplorasi ruang berbagai keadaan dan tindakan yang mungkin, hingga akhirnya menemukan pola-pola perilaku yang menghasilkan reward tinggi.
Sumber asli: Cameron R. Wolfe, Ph.D., Reinforcement Learning for LLMs: The Complete Guide, 24 Agustus 2026. Terjemahan Bahasa Indonesia untuk FLOWER — komputrobotika.com.
Bersambung ke bagian berikutnya, in sya Allah