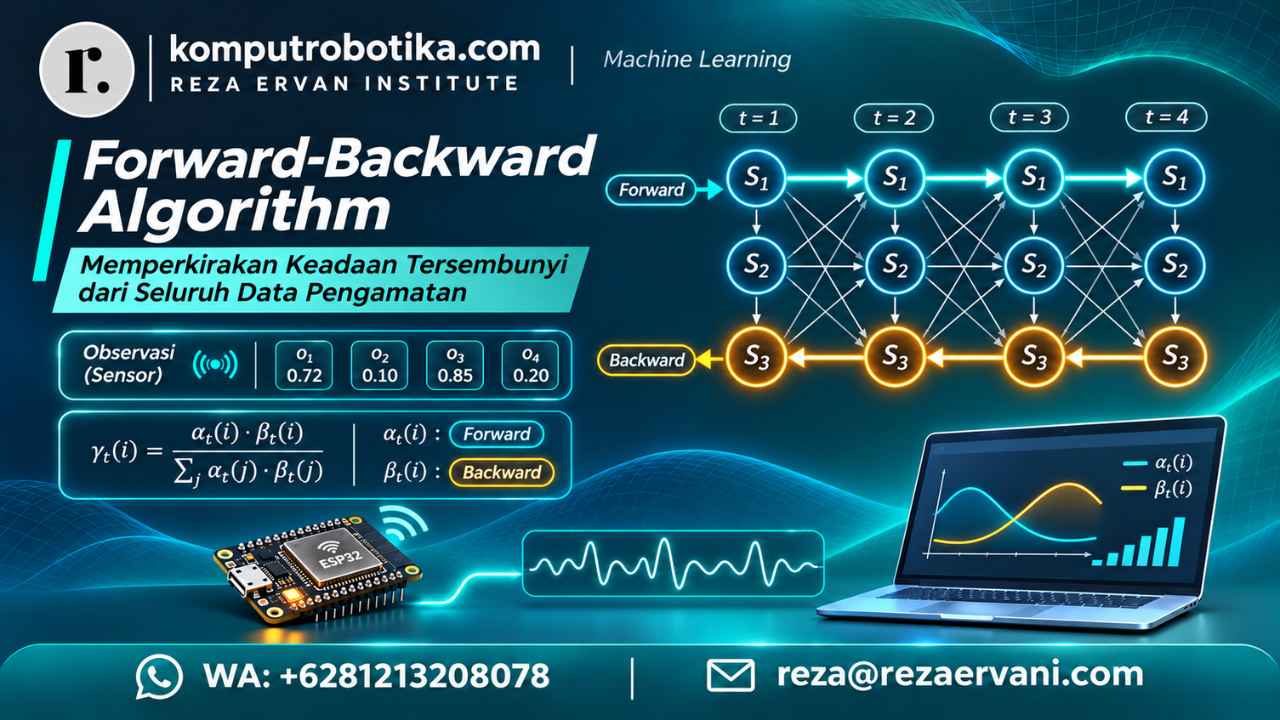
Pada pembahasan sebelumnya, kita telah mempelajari Algoritma Viterbi sebagai metode untuk menemukan urutan keadaan tersembunyi yang paling mungkin dalam Hidden Markov Model (HMM).
Kita menggunakan contoh sebuah motor listrik dengan dua kemungkinan kondisi internal, yaitu Normal dan Panas. Kondisi tersebut tidak diamati secara langsung, melainkan diperkirakan melalui pembacaan sensor suhu.
Algoritma Viterbi memungkinkan komputer memilih satu urutan keadaan yang memiliki probabilitas gabungan terbesar berdasarkan seluruh pengamatan.
Namun, bagaimana jika kita ingin mengetahui peluang motor berada dalam kondisi Panas pada waktu kedua, setelah data dari waktu ketiga dan keempat juga tersedia?
Apakah informasi yang diperoleh belakangan dapat mengubah perkiraan mengenai kondisi motor pada waktu sebelumnya?
Jawabannya adalah ya. Persoalan inilah yang membawa kita kepada Forward-Backward Algorithm, salah satu metode penting dalam inferensi probabilistik dan Hidden Markov Model.
1. Mengapa Informasi Masa Depan Dapat Membantu Memahami Masa Lalu?
Bayangkan seorang teknisi memantau suhu motor listrik menggunakan sensor.
Pada pukul 10.00, sensor menunjukkan suhu Tinggi. Teknisi kemudian memperkirakan kemungkinan motor berada dalam kondisi Panas berdasarkan informasi yang tersedia saat itu.
Namun, pada pukul 10.05 dan 10.10, sensor menghasilkan pembacaan tambahan.
Setelah seluruh data terkumpul, kita mungkin memperoleh gambaran yang lebih baik mengenai kondisi motor pada pukul 10.00.
Perhatikan bahwa informasi dari masa depan tidak mengubah kejadian yang telah berlangsung. Informasi tersebut hanya membantu kita memperbarui perkiraan terhadap keadaan masa lalu yang sebelumnya tidak diketahui dengan pasti.
Dalam teori estimasi keadaan, kita perlu membedakan dua pendekatan penting:
- Filtering: memperkirakan keadaan saat ini berdasarkan pengamatan yang tersedia hingga saat ini.
- Smoothing: memperkirakan keadaan pada waktu tertentu menggunakan seluruh pengamatan yang tersedia, termasuk pengamatan setelah waktu tersebut.
Dalam konteks HMM, Forward Algorithm dapat digunakan untuk filtering, sedangkan kombinasi Forward dan Backward memungkinkan kita melakukan smoothing.
Inilah alasan mengapa kita memerlukan algoritma yang bergerak dari dua arah.
2. Menggunakan Kembali Model Motor Listrik
Agar pembahasan dapat dibandingkan secara langsung dengan artikel sebelumnya, kita menggunakan parameter HMM yang sama.
Keadaan tersembunyi:
Normal
Panas
Pengamatan sensor:
Rendah
Tinggi
Distribusi probabilitas awal:
P(Normal) = 0.8
P(Panas)  = 0.2
Matriks probabilitas transisi:
| Keadaan Sekarang | Berikutnya Normal | Berikutnya Panas |
|---|---|---|
| Normal | 0,90 | 0,10 |
| Panas | 0,30 | 0,70 |
Matriks probabilitas emisi:
| Keadaan Tersembunyi | Sensor Rendah | Sensor Tinggi |
|---|---|---|
| Normal | 0,80 | 0,20 |
| Panas | 0,25 | 0,75 |
Angka-angka tersebut merupakan asumsi pembelajaran, bukan karakteristik motor listrik tertentu.
Sekarang, kita menggunakan empat pengamatan:
Waktu 1 : Tinggi
Waktu 2 : Tinggi
Waktu 3 : Rendah
Waktu 4 : Tinggi
Tujuan kita adalah menghitung probabilitas keadaan Normal dan Panas pada setiap waktu berdasarkan keseluruhan rangkaian pengamatan tersebut.
3. Mengingat Kembali Forward Algorithm
Forward Algorithm bekerja dari pengamatan pertama menuju pengamatan terakhir.
Algoritma ini menghitung probabilitas gabungan suatu keadaan pada waktu tertentu dengan seluruh pengamatan yang telah diterima hingga waktu tersebut.
Nilai ini biasanya dilambangkan dengan alpha.
alpha[t][i]

= P(O1, O2, ..., Ot, Xt = i)
Di sini, Ot merupakan pengamatan pada waktu t, sedangkan Xt adalah keadaan tersembunyi pada waktu tersebut.
Untuk pengamatan pertama, yaitu Tinggi, perhitungannya:
alpha[1][Normal]
= 0.8 x 0.20
= 0.16

alpha[1][Panas]
= 0.2 x 0.75
= 0.15
Dengan cara yang sama seperti artikel sebelumnya, kita melanjutkan perhitungan menggunakan matriks transisi dan emisi.
Hasil seluruh langkah Forward adalah:
| Waktu | Sensor | Alpha Normal | Alpha Panas |
|---|---|---|---|
| 1 | Tinggi | 0,16000000 | 0,15000000 |
| 2 | Tinggi | 0,03780000 | 0,09075000 |
| 3 | Rendah | 0,04899600 | 0,01682625 |
| 4 | Tinggi | 0,009828855 | 0,01250848125 |
Probabilitas memperoleh seluruh rangkaian pengamatan dihitung dengan menjumlahkan nilai alpha pada waktu terakhir.
P(Observasi)

= 0.009828855
  + 0.01250848125

= 0.02233733625
Angka ini disebut likelihood pengamatan berdasarkan parameter HMM yang digunakan.
Forward Algorithm juga memungkinkan kita menghitung peluang keadaan pada setiap waktu berdasarkan pengamatan hingga waktu tersebut.
Namun, untuk menghitung ulang keadaan pada waktu pertama dengan mempertimbangkan pengamatan hingga waktu keempat, kita membutuhkan informasi tambahan.
4. Mengenal Backward Algorithm
Berbeda dari Forward Algorithm, Backward Algorithm memulai perhitungan dari pengamatan terakhir menuju pengamatan pertama.
Nilai Backward biasanya dilambangkan dengan beta.
beta[t][i]

= P(O[t+1], ..., O[T] | Xt = i)
Artinya, beta menyatakan probabilitas seluruh pengamatan setelah waktu t, dengan syarat bahwa sistem berada dalam keadaan i pada waktu t.
Perhatikan bahwa beta tidak menghitung probabilitas keadaan i itu sendiri. Beta menghitung probabilitas pengamatan yang tersisa apabila keadaan tersebut sudah diketahui.
Jika kita berada pada waktu pengamatan terakhir, tidak ada lagi pengamatan setelahnya.
Karena itu, nilai awal Backward ditentukan sebagai:
beta[4][Normal] = 1.0

beta[4][Panas]  = 1.0
Nilai 1 tersebut menyatakan bahwa probabilitas rangkaian pengamatan kosong adalah 1.
Selanjutnya, kita menghitung mundur menuju waktu ketiga.
5. Menghitung Backward Secara Manual
Pengamatan pada waktu keempat adalah Tinggi.
Jika keadaan pada waktu ketiga adalah Normal, terdapat dua kemungkinan keadaan berikutnya:
Normal → Normal

0.9 x 0.20 = 0.18
atau:
Normal → Panas

0.1 x 0.75 = 0.075
Jumlah keduanya:
beta[3][Normal]

= 0.18 + 0.075

= 0.255
Sementara itu, jika keadaan pada waktu ketiga adalah Panas:
Panas → Normal

0.3 x 0.20 = 0.06

Panas → Panas

0.7 x 0.75 = 0.525
Sehingga:
beta[3][Panas]

= 0.06 + 0.525

= 0.585
Perhitungan ini menunjukkan bahwa apabila motor berada dalam keadaan Panas pada waktu ketiga, peluang memperoleh pembacaan Tinggi pada waktu keempat adalah 0,585 menurut model tersebut.
Selanjutnya, kita mengulangi perhitungan secara mundur untuk waktu kedua dan pertama.
Dalam bentuk umum, rumus Backward Algorithm adalah:
beta[t][i] =

jumlah untuk semua j:

A[i][j]
x B[j][observasi[t+1]]
x beta[t+1][j]
Hasil perhitungan Backward untuk seluruh waktu adalah:
| Waktu | Beta Normal | Beta Panas |
|---|---|---|
| 1 | 0,047948625 | 0,097770375 |
| 2 | 0,198225 | 0,163575 |
| 3 | 0,255000 | 0,585000 |
| 4 | 1,000000 | 1,000000 |
Nilai-nilai beta tersebut belum menyatakan probabilitas posterior keadaan tersembunyi. Kita masih harus menggabungkannya dengan nilai alpha.
6. Menggabungkan Alpha dan Beta
Sekarang kita memiliki dua kelompok informasi.
Alpha memperhitungkan seluruh pengamatan sejak awal hingga waktu tertentu, sekaligus keadaan tersembunyi pada waktu tersebut.
Beta memperhitungkan seluruh pengamatan sesudah waktu tersebut, dengan syarat keadaan tersembunyinya diketahui.
Jika keduanya dikalikan, kita memperoleh probabilitas gabungan seluruh pengamatan dan keadaan tersembunyi pada waktu tersebut.
Untuk memperoleh probabilitas keadaan tersembunyi setelah seluruh pengamatan diketahui, hasilnya harus dibagi dengan likelihood rangkaian pengamatan.
Probabilitas tersebut disebut gamma.
gamma[t][i]

= P(Xt = i | O1, ..., OT)

= alpha[t][i] x beta[t][i]
  -------------------------
         P(Observasi)
Dalam HMM, gamma merupakan probabilitas posterior keadaan tersembunyi pada waktu tertentu dengan mempertimbangkan seluruh rangkaian pengamatan.
Inilah hasil utama yang kita perlukan untuk melakukan smoothing.
7. Contoh: Memperkirakan Kondisi Motor pada Waktu Pertama
Mari kita kembali ke pengamatan pertama, yaitu Tinggi.
Jika kita hanya menggunakan pengamatan pertama, hasil filtering adalah:
P(Normal | Tinggi)
= 0.16 / 0.31
≈ 0.5161

P(Panas | Tinggi)
= 0.15 / 0.31
≈ 0.4839
Artinya, berdasarkan pengamatan pertama saja, Normal masih merupakan keadaan yang sedikit lebih mungkin.
Namun, setelah seluruh empat pengamatan tersedia, kita dapat menghitung ulang menggunakan Forward-Backward.
Untuk keadaan Normal:
gamma[1][Normal]

= 0.16 x 0.047948625
  ------------------
     0.02233733625

≈ 0.3435
Untuk keadaan Panas:
gamma[1][Panas]

= 0.15 x 0.097770375
  ------------------
     0.02233733625

≈ 0.6565
Hasilnya cukup menarik.
Jika hanya menggunakan pembacaan pertama, peluang Panas adalah sekitar 48,39%.
Namun, setelah seluruh pengamatan hingga waktu keempat diperhitungkan, peluang Panas pada waktu pertama menjadi sekitar 65,65%.
Perkiraan kita tentang keadaan sebelumnya berubah karena informasi tambahan memberikan bukti probabilistik baru.
Sekali lagi, kejadian masa lalu tidak berubah. Yang berubah adalah pengetahuan kita mengenai kejadian tersebut.
8. Hasil Smoothing untuk Seluruh Pengamatan
Dengan menggabungkan alpha dan beta pada setiap waktu, kita memperoleh:
| Waktu | Sensor | P(Normal) | P(Panas) |
|---|---|---|---|
| 1 | Tinggi | 34,35% | 65,65% |
| 2 | Tinggi | 33,54% | 66,46% |
| 3 | Rendah | 55,93% | 44,07% |
| 4 | Tinggi | 44,00% | 56,00% |
Setiap baris menunjukkan probabilitas keadaan tersembunyi pada waktu tertentu setelah seluruh empat pengamatan digunakan.
Jumlah probabilitas Normal dan Panas pada setiap waktu adalah 100%, dengan kemungkinan sedikit perbedaan akibat pembulatan.
Perhatikan bahwa pada waktu ketiga, keadaan Normal memiliki probabilitas lebih besar, meskipun pada waktu pertama dan kedua keadaan Panas lebih mungkin.
Hasil ini akan membantu kita memahami perbedaan antara Forward-Backward dan Viterbi.
9. Mengapa Hasilnya Berbeda dari Viterbi?
Pada artikel sebelumnya, kita menggunakan Algoritma Viterbi untuk mencari satu urutan keadaan tersembunyi yang memiliki probabilitas gabungan terbesar.
Dengan parameter dan pengamatan yang sama, Viterbi menghasilkan:
Panas → Panas → Panas → Panas
Sementara itu, jika kita memilih keadaan dengan probabilitas posterior terbesar pada setiap waktu dari hasil Forward-Backward, kita memperoleh:
Panas → Panas → Normal → Panas
Mengapa berbeda?
Karena kedua metode menjawab pertanyaan yang berbeda.
Viterbi mencari satu urutan keadaan lengkap yang paling mungkin secara keseluruhan.
Sementara Forward-Backward menghitung probabilitas masing-masing keadaan pada setiap waktu, dengan mempertimbangkan seluruh kemungkinan jalur yang konsisten dengan pengamatan.
Ketika kita memilih keadaan berdasarkan gamma terbesar pada setiap waktu, kita sedang memilih keadaan yang secara individual paling mungkin pada waktu tersebut.
Hasil pemilihan secara individual tidak harus sama dengan satu urutan yang memiliki probabilitas gabungan terbesar.
Bahkan pada model tertentu, penggabungan keadaan paling mungkin secara individual dapat menghasilkan urutan yang memiliki probabilitas transisi nol. Karena itu, metode decoding harus dipilih sesuai dengan tujuan analisis.
10. Praktikum Python: Forward-Backward Tanpa Pustaka Tambahan
Untuk mempelajari cara kerjanya, mari kita membuat implementasi Forward-Backward menggunakan Python dasar.
Program berikut menggunakan kembali seluruh parameter HMM dari seri sebelumnya.
# ==========================================
# Praktikum Forward-Backward Algorithm
# KOMPUTROBOTIKA
# ==========================================

states = ["Normal", "Panas"]

observations = [
    "Tinggi",
    "Tinggi",
    "Rendah",
    "Tinggi"
]

initial = {
    "Normal": 0.8,
    "Panas": 0.2
}

transition = {
    "Normal": {
        "Normal": 0.9,
        "Panas": 0.1
    },
    "Panas": {
        "Normal": 0.3,
        "Panas": 0.7
    }
}

emission = {
    "Normal": {
        "Rendah": 0.80,
        "Tinggi": 0.20
    },
    "Panas": {
        "Rendah": 0.25,
        "Tinggi": 0.75
    }
}

T = len(observations)

# ------------------------------------------
# 1. FORWARD
# ------------------------------------------

alpha = []

first_alpha = {}

for state in states:
    first_alpha[state] = (
        initial[state]
        * emission[state][observations[0]]
    )

alpha.append(first_alpha)

for t in range(1, T):

    current_alpha = {}

    for current_state in states:

        total = sum(
            alpha[t - 1][previous_state]
            * transition[previous_state][current_state]
            for previous_state in states
        )

        current_alpha[current_state] = (
            total
            * emission[current_state][observations[t]]
        )

    alpha.append(current_alpha)

# ------------------------------------------
# 2. BACKWARD
# ------------------------------------------

beta = [{} for _ in range(T)]

for state in states:
    beta[T - 1][state] = 1.0

for t in range(T - 2, -1, -1):

    for current_state in states:

        beta[t][current_state] = sum(
            transition[current_state][next_state]
            * emission[next_state][observations[t + 1]]
            * beta[t + 1][next_state]
            for next_state in states
        )

# ------------------------------------------
# 3. LIKELIHOOD
# ------------------------------------------

likelihood = sum(alpha[T - 1].values())

if likelihood <= 0:
    raise ValueError(
        "Rangkaian pengamatan tidak mungkin "
        "menurut parameter model."
    )

# ------------------------------------------
# 4. SMOOTHING
# ------------------------------------------

gamma = []

for t in range(T):

    posterior = {}

    for state in states:

        posterior[state] = (
            alpha[t][state]
            * beta[t][state]
            / likelihood
        )

    gamma.append(posterior)

# ------------------------------------------
# 5. MENAMPILKAN HASIL
# ------------------------------------------

print("FORWARD-BACKWARD ALGORITHM")
print()

print(
    "Likelihood:",
    f"{likelihood:.11f}"
)

print()

for t in range(T):

    filtered_total = sum(alpha[t].values())

    filtered_panas = (
        alpha[t]["Panas"] / filtered_total
    )

    smoothed_panas = gamma[t]["Panas"]

    best_state = max(
        gamma[t],
        key=gamma[t].get
    )

    print(
        f"Waktu {t + 1} "
        f"({observations[t]})"
    )

    print(
        f"  Filtering Panas: "
        f"{filtered_panas:.4f}"
    )

    print(
        f"  Smoothing Panas: "
        f"{smoothed_panas:.4f}"
    )

    print(
        f"  Keadaan posterior terbesar: "
        f"{best_state}"
    )

    print()
Program tersebut dibagi menjadi lima tahap.
Pertama, perhitungan Forward dilakukan dari awal menuju akhir pengamatan.
Kedua, perhitungan Backward dilakukan dari akhir menuju awal.
Ketiga, kita menghitung likelihood seluruh rangkaian pengamatan.
Keempat, alpha dan beta digabungkan untuk menghasilkan distribusi posterior keadaan tersembunyi.
Kelima, hasil filtering dan smoothing ditampilkan untuk dibandingkan.
Dalam contoh dengan empat pengamatan ini, angka probabilitas cukup besar untuk dihitung menggunakan floating-point biasa.
Namun, untuk rangkaian pengamatan yang panjang, perkalian probabilitas yang terus berulang dapat menyebabkan numerical underflow. Implementasi yang lebih lanjut menggunakan scaling atau perhitungan dalam ruang logaritmik agar lebih stabil.
11. Hasil yang Diharapkan
Ketika program dijalankan, hasil utamanya adalah:
FORWARD-BACKWARD ALGORITHM

Likelihood: 0.02233733625

Waktu 1 (Tinggi)
  Filtering Panas: 0.4839
  Smoothing Panas: 0.6565
  Keadaan posterior terbesar: Panas

Waktu 2 (Tinggi)
  Filtering Panas: 0.7060
  Smoothing Panas: 0.6646
  Keadaan posterior terbesar: Panas

Waktu 3 (Rendah)
  Filtering Panas: 0.2556
  Smoothing Panas: 0.4407
  Keadaan posterior terbesar: Normal

Waktu 4 (Tinggi)
  Filtering Panas: 0.5600
  Smoothing Panas: 0.5600
  Keadaan posterior terbesar: Panas
Perhatikan bahwa filtering dan smoothing tidak selalu menghasilkan probabilitas yang sama.
Pada waktu pertama, smoothing menggunakan informasi dari tiga pengamatan setelahnya. Karena itu, hasilnya berbeda dari filtering.
Pada waktu keempat, kedua hasil sama karena waktu keempat merupakan akhir rangkaian pengamatan. Tidak ada data berikutnya yang dapat digunakan untuk memperbarui perkiraan.
Perbedaan tersebut merupakan salah satu hal penting yang perlu dipahami sebelum menggunakan HMM pada sistem pemantauan kondisi perangkat.
12. Hubungannya dengan ESP32 dan Pemantauan Motor Listrik
Dalam praktikum IoT, kita dapat menggunakan ESP32 untuk mengumpulkan data suhu atau besaran fisis lainnya secara berkala.
Misalnya, sistem merekam data suhu setiap lima detik, kemudian menyimpannya ke database atau berkas CSV.
Data tersebut dapat diproses menggunakan model probabilistik untuk memperkirakan kondisi perangkat.
Alur pengamatannya:
Motor Listrik
      |
      v
Sensor Suhu
      |
      v
ESP32
      |
      v
Data Suhu Berkala
      |
      v
Klasifikasi Pengamatan
Rendah / Tinggi
      |
      v
Hidden Markov Model
      |
      +----------------+
      |                |
      v                v
Forward           Backward
      |                |
      +--------+-------+
               |
               v
       Posterior Keadaan
               |
               v
       Analisis Kondisi
Perlu diperhatikan bahwa Forward-Backward dalam bentuk ini menggunakan keseluruhan rangkaian pengamatan yang sudah dikumpulkan.
Karena itu, smoothing sangat sesuai untuk analisis setelah data tersedia, seperti meninjau riwayat kondisi motor selama periode tertentu.
Jika kita membutuhkan estimasi keadaan secara langsung ketika sensor mengirim data baru, filtering lebih sesuai karena hanya membutuhkan pengamatan yang telah tersedia.
Keduanya dapat digunakan dalam sebuah sistem yang sama untuk tujuan berbeda.
Misalnya, filtering digunakan untuk memperbarui indikator kondisi motor secara langsung, sedangkan smoothing digunakan untuk menganalisis ulang riwayat pengamatan setelah lebih banyak data terkumpul.
13. Mengapa Model Tetap Harus Diuji?
Dalam contoh ini, kita menggunakan probabilitas awal, transisi, dan emisi yang sudah ditentukan.
Namun, bagaimana jika angka-angka tersebut tidak sesuai dengan karakteristik motor yang sebenarnya?
Hasil perhitungan tetap dapat terlihat rapi dan konsisten secara matematis, tetapi perkiraan kondisi motor mungkin tidak akurat.
Ini menunjukkan perbedaan penting antara ketepatan perhitungan algoritma dan kesesuaian model terhadap kenyataan.
Algoritma dapat menghitung probabilitas dengan benar berdasarkan parameter yang diberikan, tetapi kualitas kesimpulan tetap bergantung pada kualitas parameter dan asumsi model.
Dalam praktikum nyata, kita perlu memperhatikan ketelitian sensor, interval pengukuran, kriteria kondisi motor, serta keberadaan data pembanding untuk mengevaluasi hasil model.
Kita juga harus mengingat bahwa kategori pembacaan Tinggi atau Rendah tidak otomatis merupakan diagnosis kondisi internal motor.
14. Latihan dan Eksperimen
Untuk memperdalam pemahaman, lakukan beberapa eksperimen berikut.
- Ubah urutan pengamatan menjadi Rendah, Tinggi, Tinggi, Rendah, lalu bandingkan hasil filtering dan smoothing.
- Tambahkan pengamatan kelima, kemudian periksa apakah probabilitas kondisi pada waktu pertama berubah.
- Ubah probabilitas awal Normal dan Panas menjadi masing-masing 0,5.
- Ubah probabilitas transisi dan periksa bagaimana pengaruhnya terhadap posterior keadaan.
- Bandingkan hasil Forward-Backward dengan urutan keadaan terbaik yang diperoleh dari program Viterbi sebelumnya.
- Buat grafik probabilitas Panas terhadap waktu agar perbedaan filtering dan smoothing lebih mudah diamati.
Pada latihan terakhir, gunakan sumbu horizontal untuk waktu pengamatan dan sumbu vertikal untuk probabilitas keadaan Panas.
Dengan demikian, kita dapat melihat secara visual bagaimana informasi pengamatan berikutnya memengaruhi perkiraan keadaan pada waktu sebelumnya.
15. Dari Forward-Backward Menuju Pembelajaran Parameter
Sejauh ini, kita telah menggunakan HMM dengan parameter yang diketahui.
Namun, dalam persoalan nyata, keadaan tersembunyi sering kali tidak memiliki label yang dapat diamati secara langsung.
Jika demikian, bagaimana komputer mempelajari probabilitas transisi dan emisi dari data pengamatan?
Salah satu pendekatannya adalah algoritma Baum-Welch, yang merupakan bentuk Expectation-Maximization (EM) untuk Hidden Markov Model.
Dalam algoritma tersebut, hasil perhitungan Forward-Backward digunakan untuk memperkirakan kontribusi probabilistik keadaan tersembunyi dan perpindahan antar-keadaan.
Perkiraan tersebut kemudian digunakan untuk memperbarui parameter model secara berulang.
Inilah salah satu jembatan penting menuju unsupervised learning, yaitu pembelajaran pola dari data tanpa membutuhkan label keadaan tersembunyi untuk setiap pengamatan.
16. Penutup
Forward-Backward Algorithm memperlihatkan bagaimana komputer dapat memanfaatkan seluruh rangkaian pengamatan untuk memperkirakan keadaan tersembunyi pada waktu tertentu.
Melalui Forward Algorithm, kita menghitung kontribusi probabilistik dari pengamatan sebelumnya. Melalui Backward Algorithm, kita menghitung kontribusi pengamatan berikutnya.
Keduanya kemudian digabungkan untuk memperoleh probabilitas posterior keadaan tersembunyi.
Dalam contoh motor listrik, kita melihat bahwa informasi yang dikumpulkan kemudian dapat mengubah perkiraan mengenai kondisi motor pada waktu sebelumnya.
Namun, penting untuk tetap membedakan probabilitas hasil model dengan kondisi fisis yang telah terbukti melalui pengukuran atau pemeriksaan langsung.
Dengan memahami Forward-Backward, kita telah menambahkan satu konsep penting dalam rangkaian pembelajaran probabilitas, proses stokastik, dan Machine Learning: kemampuan untuk memperbarui perkiraan keadaan berdasarkan informasi yang lebih lengkap.
Pada seri berikutnya, kita akan mempelajari Baum-Welch Algorithm dan melihat bagaimana komputer dapat memperkirakan parameter Hidden Markov Model dari data pengamatan, tanpa harus menentukan seluruh nilai probabilitas secara manual.
Referensi
- Rabiner, Lawrence R. (1989). A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition. Proceedings of the IEEE, 77(2), 257–286. DOI: 10.1109/5.18626.
- Jurafsky, Daniel, dan James H. Martin (2026 draft). Speech and Language Processing: Hidden Markov Models. Stanford University. Baca materi.