Pada pembahasan sebelumnya, kita telah mempelajari probabilitas bersyarat, yaitu peluang suatu kejadian ketika informasi mengenai kejadian atau kondisi lain telah diketahui.
Kita menggunakan contoh bola berwarna, cuaca, dan data pengamatan untuk melihat bagaimana informasi tambahan dapat mengubah hasil perhitungan peluang.
Namun, terdapat pertanyaan lain yang tidak kalah penting.
Bagaimana jika kita tidak hanya ingin mengetahui peluang satu kejadian, tetapi ingin mengetahui peluang dari seluruh kemungkinan hasil yang dapat terjadi?
Misalnya, ketika melempar dadu, kita tidak cukup hanya mengetahui peluang munculnya angka enam. Kita mungkin ingin mengetahui peluang munculnya angka satu, dua, tiga, empat, lima, dan enam sekaligus.
Demikian pula ketika membuat sistem prediksi cuaca. Komputer mungkin perlu mengetahui peluang keadaan Cerah, Berawan, dan Hujan, bukan hanya peluang Hujan.
Untuk menyusun informasi tersebut secara sistematis, kita memerlukan konsep distribusi probabilitas (probability distribution).
1. Memulai dari Sebuah Kotak Berisi Bola
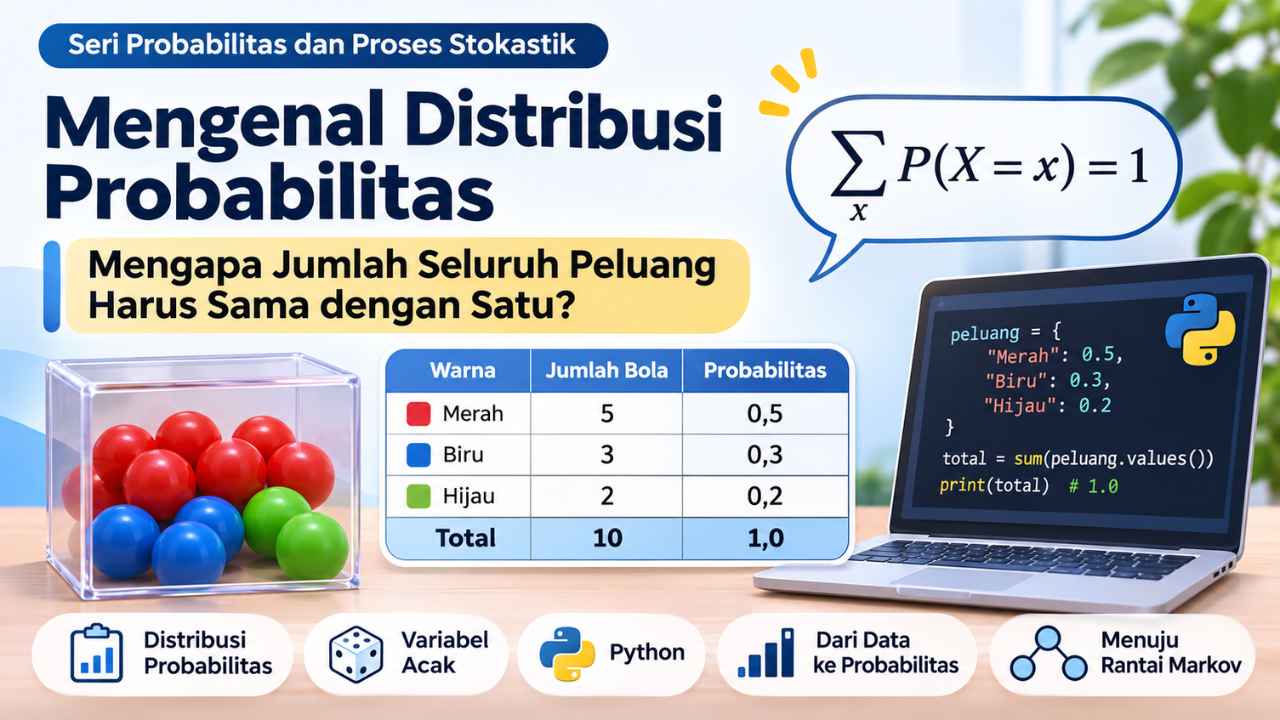
Bayangkan sebuah kotak yang berisi sepuluh bola dengan komposisi berikut:
- 5 bola berwarna merah.
- 3 bola berwarna biru.
- 2 bola berwarna hijau.
Kita mengambil satu bola secara acak. Setiap bola memiliki peluang yang sama untuk terambil.
Berapa peluang memperoleh bola merah?
P(Merah) = 5 / 10 = 0.5
Peluang mendapatkan bola biru:
P(Biru) = 3 / 10 = 0.3
Sementara peluang mendapatkan bola hijau:
P(Hijau) = 2 / 10 = 0.2
Ketiga nilai tersebut dapat kita susun menjadi sebuah tabel.
| Warna | Jumlah Bola | Probabilitas |
|---|---|---|
| Merah | 5 | 0,5 atau 50% |
| Biru | 3 | 0,3 atau 30% |
| Hijau | 2 | 0,2 atau 20% |
| Total | 10 | 1,0 atau 100% |
Tabel tersebut merupakan contoh sederhana distribusi probabilitas diskret.
Kita menyebutnya distribusi karena peluang tidak hanya dinyatakan untuk satu hasil, tetapi dibagikan kepada seluruh kemungkinan hasil yang telah kita definisikan.
2. Mengapa Jumlah Probabilitas Harus Sama dengan Satu?
Perhatikan kembali nilai probabilitas dari tiga warna bola:
Merah = 0.5
Biru  = 0.3
Hijau = 0.2

Jumlah = 0.5 + 0.3 + 0.2

       = 1.0
Mengapa jumlahnya harus satu?
Karena dalam percobaan ini, kita pasti mengambil satu bola, dan bola tersebut pasti berwarna Merah, Biru, atau Hijau.
Ketiga kemungkinan itu memenuhi dua sifat penting.
Pertama, ketiganya saling lepas. Satu bola yang terambil tidak sekaligus dianggap merah dan biru.
Kedua, ketiganya mencakup seluruh kemungkinan hasil. Tidak ada warna lain dalam kotak tersebut.
Karena seluruh kemungkinan telah diperhitungkan, jumlah probabilitasnya harus sama dengan satu atau 100%.
Secara umum, untuk variabel acak diskret X yang memiliki kemungkinan nilai x1, x2, hingga xn, berlaku:
P(X = x1)
+ P(X = x2)
+ ...
+ P(X = xn)
= 1
Setiap nilai probabilitas juga harus berada di antara nol dan satu.
0 <= P(X = xi) <= 1
Nilai nol menunjukkan bahwa suatu hasil memiliki probabilitas nol menurut model. Nilai satu menunjukkan bahwa hasil tersebut pasti terjadi menurut model.
Kedua sifat ini menjadi dasar untuk memeriksa apakah sebuah tabel peluang sudah valid.
3. Apa yang Terjadi Jika Jumlahnya Tidak Sama dengan Satu?
Misalnya, seorang programmer menuliskan distribusi berikut:
Merah = 0.5
Biru  = 0.4
Hijau = 0.3

Jumlah = 1.2
Jumlah probabilitas mencapai 120%.
Apakah nilai tersebut dapat digunakan sebagai distribusi probabilitas yang valid untuk tiga hasil yang saling lepas dan mencakup seluruh kemungkinan?
Tidak.
Jumlah tersebut menunjukkan bahwa terdapat kesalahan dalam nilai yang ditentukan atau dalam cara mendefinisikan hasil percobaan.
Contoh lain:
Merah = 0.5
Biru  = 0.2
Hijau = 0.1

Jumlah = 0.8
Jumlahnya hanya 80%.
Jika hanya tiga warna tersebut yang mungkin muncul, masih terdapat 20% probabilitas yang belum teralokasikan.
Hal ini dapat terjadi karena kita melewatkan suatu kemungkinan, menggunakan data yang tidak lengkap, atau salah menghitung peluang.
Namun, aturan jumlah sama dengan satu berlaku untuk seluruh kemungkinan yang saling lepas dan mencakup seluruh hasil. Kita tidak boleh sembarangan menjumlahkan probabilitas kejadian yang saling tumpang tindih.
4. Dari Warna Bola Menuju Variabel Acak
Dalam matematika, hasil suatu percobaan sering direpresentasikan menggunakan variabel acak atau random variable.
Variabel acak adalah fungsi yang memberikan nilai numerik pada hasil-hasil suatu percobaan acak.
Misalnya, kita membuat variabel X untuk pengambilan bola:
X = 1 jika bola Merah
X = 2 jika bola Biru
X = 3 jika bola Hijau
Dengan demikian, distribusi probabilitas X adalah:
P(X = 1) = 0.5

P(X = 2) = 0.3

P(X = 3) = 0.2
Angka satu, dua, dan tiga dalam contoh ini hanyalah kode untuk membedakan warna. Angka tersebut tidak menunjukkan tingkat kepentingan atau urutan kualitas warna.
Dalam pemrograman, kita sering menggunakan label teks seperti Merah, Biru, dan Hijau secara langsung. Namun, untuk pembahasan matematika formal, variabel acak dapat dibuat dengan memberikan nilai numerik pada masing-masing hasil.
5. Mengenal Distribusi Probabilitas Diskret
Distribusi yang kita gunakan pada contoh warna bola disebut distribusi probabilitas diskret.
Disebut diskret karena kemungkinan nilainya dapat didaftarkan satu per satu, baik dalam jumlah terbatas maupun tak terbatas yang dapat dihitung.
Contoh lainnya adalah hasil pelemparan sebuah dadu ideal.
Sebuah dadu memiliki enam kemungkinan hasil dengan probabilitas yang sama.
| Hasil Dadu | Probabilitas |
|---|---|
| 1 | 1/6 |
| 2 | 1/6 |
| 3 | 1/6 |
| 4 | 1/6 |
| 5 | 1/6 |
| 6 | 1/6 |
Jumlahnya adalah:
6 x (1/6) = 1
Namun, sebuah distribusi tidak harus memberikan probabilitas yang sama kepada setiap hasil.
Pada contoh bola, probabilitas Merah adalah 50%, sedangkan probabilitas Hijau hanya 20%.
Yang diperlukan adalah seluruh nilai probabilitas valid dan jumlahnya sama dengan satu.
6. Membuat Distribusi Probabilitas dalam Python
Sekarang kita akan menggunakan Python untuk merepresentasikan distribusi probabilitas.
Kita mulai menggunakan dictionary, yaitu struktur data Python yang menyimpan pasangan key dan value.
# Distribusi probabilitas warna bola

peluang = {
    "Merah": 0.5,
    "Biru": 0.3,
    "Hijau": 0.2
}

for warna, probabilitas in peluang.items():

    print(
        warna,
        "=",
        probabilitas
    )
Hasilnya:
Merah = 0.5
Biru = 0.3
Hijau = 0.2
Dalam program tersebut, nama warna menjadi key, sedangkan nilai probabilitas menjadi value.
Dengan struktur ini, kita dapat mengambil peluang suatu warna secara langsung.
print(peluang["Merah"])
Hasilnya:
0.5
Ini menunjukkan bahwa sebuah distribusi probabilitas dapat direpresentasikan menggunakan struktur data sederhana, tanpa membutuhkan pustaka Machine Learning.
7. Memeriksa Jumlah Probabilitas secara Otomatis
Dalam sistem komputasi, kita tidak sebaiknya mengandalkan pemeriksaan manual untuk setiap distribusi.
Kita dapat meminta Python menjumlahkan seluruh nilai menggunakan fungsi sum().
peluang = {
    "Merah": 0.5,
    "Biru": 0.3,
    "Hijau": 0.2
}

total = sum(peluang.values())

print("Total probabilitas:", total)
Hasilnya:
Total probabilitas: 1.0
Kita juga dapat membuat pemeriksaan sederhana menggunakan sebuah fungsi.
def distribusi_valid(peluang):

    if not peluang:
        return False

    # Semua peluang harus berada
    # antara nol dan satu.

    for nilai in peluang.values():

        if not 0.0 <= nilai <= 1.0:
            return False

    # Gunakan toleransi kecil karena
    # komputer memakai floating point.

    total = sum(peluang.values())

    return abs(total - 1.0) < 1e-9


peluang = {
    "Merah": 0.5,
    "Biru": 0.3,
    "Hijau": 0.2
}

print(distribusi_valid(peluang))
Hasil:
True
Mengapa kita tidak selalu menggunakan pemeriksaan seperti total == 1.0?
Karena komputer menyimpan banyak bilangan desimal menggunakan representasi floating-point yang memiliki keterbatasan presisi.
Misalnya, dalam Python:
print(0.1 + 0.2)
Hasilnya dapat berupa:
0.30000000000000004
Ini bukan berarti komputer tidak memahami penjumlahan. Hasil tersebut berkaitan dengan cara sebagian bilangan desimal direpresentasikan dalam sistem bilangan biner.
Karena itu, untuk pemeriksaan numerik sederhana, kita dapat menggunakan toleransi kesalahan yang kecil.
8. Bagaimana Jika Kita Memiliki Data Pengamatan?
Sebelumnya, probabilitas kita tentukan berdasarkan jumlah bola yang sudah diketahui.
Namun, dalam banyak persoalan nyata, kita tidak memiliki probabilitas yang sudah tersedia.
Yang kita miliki justru data hasil pengamatan.
Misalnya, sebuah sensor menghasilkan sepuluh kategori pembacaan berikut:
Rendah
Sedang
Rendah
Tinggi
Sedang
Rendah
Sedang
Tinggi
Rendah
Sedang
Jika kita menghitung jumlah kemunculan setiap kategori, diperoleh:
| Kategori | Jumlah | Frekuensi Relatif |
|---|---|---|
| Rendah | 4 | 0,4 |
| Sedang | 4 | 0,4 |
| Tinggi | 2 | 0,2 |
| Total | 10 | 1,0 |
Dari frekuensi relatif tersebut, kita memperoleh estimasi distribusi probabilitas kategori pembacaan sensor.
Misalnya:
P(Rendah) ≈ 0.4

P(Sedang) ≈ 0.4

P(Tinggi) ≈ 0.2
Tanda mendekati digunakan karena nilai tersebut merupakan perkiraan berdasarkan sampel pengamatan, bukan probabilitas yang pasti berlaku pada seluruh kondisi sistem.
Semakin baik data mewakili proses yang diamati, semakin berguna estimasi yang dapat kita peroleh.
9. Praktikum Python: Menghitung Distribusi dari Data
Mari kita meminta Python menghitung distribusi probabilitas berdasarkan sepuluh pembacaan tadi.
from collections import Counter

# Contoh data pembacaan sensor

data = [
    "Rendah",
    "Sedang",
    "Rendah",
    "Tinggi",
    "Sedang",
    "Rendah",
    "Sedang",
    "Tinggi",
    "Rendah",
    "Sedang"
]

# Menghitung kemunculan
jumlah = Counter(data)

# Jumlah seluruh pengamatan
total = len(data)

# Menghitung distribusi
for kategori in [
    "Rendah",
    "Sedang",
    "Tinggi"
]:

    frekuensi = jumlah[kategori]

    probabilitas = frekuensi / total

    print(
        f"{kategori}: "
        f"{probabilitas:.2f}"
    )
Hasilnya:
Rendah: 0.40
Sedang: 0.40
Tinggi: 0.20
Program tersebut melakukan tiga pekerjaan utama:
- Menghitung berapa kali masing-masing kategori muncul.
- Menghitung jumlah seluruh pengamatan.
- Membagi jumlah kemunculan kategori dengan jumlah seluruh pengamatan.
Hasil akhirnya merupakan distribusi frekuensi relatif yang dapat digunakan sebagai estimasi distribusi probabilitas diskret.
Ini merupakan contoh sederhana bagaimana komputer memperoleh informasi probabilistik dari data.
10. Membedakan Distribusi Probabilitas dan Satu Hasil Pengamatan
Ada perbedaan penting yang perlu kita pahami sebelum melanjutkan.
Bayangkan sebuah model cuaca menghasilkan distribusi berikut:
Cerah   = 0.60
Berawan = 0.25
Hujan   = 0.15
Angka-angka tersebut menjelaskan peluang masing-masing keadaan menurut model.
Namun, cuaca yang benar-benar terjadi pada suatu waktu hanya salah satu dari kemungkinan tersebut, misalnya Hujan.
Terjadinya Hujan tidak otomatis membuktikan bahwa model salah hanya karena peluang Hujan sebesar 15%.
Peristiwa dengan probabilitas kecil tetap dapat terjadi.
Untuk menilai kualitas sebuah model probabilistik, kita perlu menggunakan banyak pengamatan serta metode evaluasi yang sesuai.
Inilah perbedaan antara prediksi probabilistik dan prediksi deterministik.
Model probabilistik menyatakan ketidakpastian mengenai berbagai kemungkinan, sedangkan sebuah hasil pengamatan menunjukkan keadaan yang benar-benar teramati.
11. Mengapa Komputer Perlu Menyimpan Seluruh Distribusi?
Misalnya, sebuah program hanya mengeluarkan prediksi:
Besok kemungkinan besar Cerah
Informasi tersebut memang berguna, tetapi belum menjelaskan seberapa besar ketidakpastiannya.
Bandingkan dua model berikut:
| Keadaan | Model A | Model B |
|---|---|---|
| Cerah | 0,90 | 0,40 |
| Berawan | 0,05 | 0,35 |
| Hujan | 0,05 | 0,25 |
| Total | 1,00 | 1,00 |
Kedua model memberikan peluang terbesar kepada keadaan Cerah.
Namun, Model A memberikan peluang Cerah sebesar 90%, sedangkan Model B hanya 40%.
Model A memiliki distribusi yang lebih terkonsentrasi pada satu keadaan, sementara Model B membagikan peluang kepada beberapa keadaan dengan nilai yang relatif berdekatan.
Jika komputer hanya mengeluarkan label Cerah, perbedaan tersebut tidak terlihat.
Dengan mempertahankan distribusi probabilitas, program dapat memberikan informasi yang lebih kaya untuk pengambilan keputusan.
Namun, distribusi yang lebih terkonsentrasi tidak otomatis lebih benar. Ketepatan probabilitas model tetap harus diperiksa terhadap data.
12. Dari Tabel Menuju Vektor Probabilitas
Dalam pemrograman dan matematika komputasi, distribusi probabilitas juga dapat dinyatakan sebagai daftar angka yang tersusun menurut urutan tertentu.
Misalnya:
Urutan keadaan:

1. Cerah
2. Berawan
3. Hujan

Distribusi:

[0.60, 0.25, 0.15]
Dalam matematika, susunan tersebut dapat disebut vektor probabilitas.
Dalam Python, kita dapat merepresentasikannya menggunakan list.
keadaan = [
    "Cerah",
    "Berawan",
    "Hujan"
]

peluang = [
    0.60,
    0.25,
    0.15
]

for nama, nilai in zip(
    keadaan,
    peluang
):

    print(
        nama,
        "=",
        nilai
    )
Penting untuk mempertahankan urutan yang konsisten antara daftar keadaan dan daftar probabilitas.
Jika urutan keadaan berubah tetapi urutan probabilitas tidak ikut disesuaikan, program dapat menafsirkan peluang untuk keadaan yang salah.
Vektor probabilitas inilah yang nantinya akan kita gunakan ketika mempelajari perhitungan perubahan keadaan melalui matriks transisi.
13. Hubungannya dengan Rantai Markov
Dalam Rantai Markov, kita ingin mempelajari bagaimana probabilitas keadaan sistem berubah dari satu waktu ke waktu berikutnya.
Misalnya, kita mempunyai dua keadaan:
Cerah
Hujan
Jika hari ini dipastikan Cerah, distribusi keadaan hari ini adalah:
[1.0, 0.0]
Artinya, peluang Cerah adalah 100%, sedangkan peluang Hujan adalah 0%.
Jika kita memiliki aturan perpindahan:
- Dari Cerah menuju Cerah: 80%.
- Dari Cerah menuju Hujan: 20%.
Maka distribusi keadaan besok adalah:
[0.8, 0.2]
Jika kita hanya mengetahui bahwa hari ini mempunyai peluang Cerah 60% dan Hujan 40%, perhitungan keadaan besok harus mempertimbangkan kemungkinan perpindahan dari kedua keadaan awal tersebut.
Di sinilah matriks transisi menjadi penting.
Namun, sebelum mempelajari perkalian matriks, kita harus memahami bahwa vektor probabilitas menunjukkan distribusi peluang pada satu waktu, sedangkan matriks transisi menunjukkan aturan perpindahan peluang antar-keadaan.
Keduanya berhubungan, tetapi mempunyai fungsi yang berbeda.
14. Bagaimana dengan Suhu yang Nilainya Kontinu?
Dalam contoh sebelumnya, kita menggunakan kategori seperti Rendah, Sedang, dan Tinggi.
Namun, suhu sebenarnya dapat berupa nilai kontinu, misalnya 28,1 derajat Celsius, 28,15 derajat Celsius, atau 28,153 derajat Celsius.
Untuk variabel acak kontinu, kita biasanya menggunakan konsep distribusi probabilitas kontinu dan fungsi kepadatan probabilitas atau probability density function (PDF).
Dalam distribusi kontinu, nilai fungsi kepadatan bukan probabilitas tepat pada satu titik. Probabilitas suatu rentang diperoleh dari luas di bawah kurva kepadatan pada rentang tersebut.
Seluruh luas di bawah kurva kepadatan harus sama dengan satu.
Konsep tersebut merupakan perluasan dari gagasan yang telah kita pelajari: seluruh probabilitas dari semua kemungkinan harus berjumlah satu.
Untuk pembahasan kali ini, kita cukup memahami distribusi diskret terlebih dahulu karena kategori keadaan dalam contoh Rantai Markov kita dapat didaftarkan satu per satu.
15. Latihan dan Eksperimen
Untuk memastikan konsep distribusi probabilitas benar-benar dipahami, lakukan beberapa latihan berikut.
- Sebuah kotak berisi 4 bola merah, 4 bola biru, dan 2 bola hijau. Hitung distribusi probabilitas warnanya.
- Periksa apakah distribusi [0.2, 0.5, 0.3] valid.
- Periksa apakah distribusi [0.4, 0.4, 0.4] valid dan jelaskan alasannya.
- Ubah program Python untuk menghitung distribusi empat kategori, bukan tiga kategori.
- Tambahkan sepuluh pembacaan sensor baru, kemudian bandingkan perubahan frekuensi relatifnya.
- Buat dua distribusi cuaca yang sama-sama memprediksi Cerah sebagai keadaan paling mungkin, tetapi mempunyai tingkat ketidakpastian yang berbeda.
Ketika melakukan eksperimen, jangan hanya memperhatikan angka yang dihasilkan.
Periksa juga apakah seluruh kategori telah dimasukkan, apakah kategori tersebut saling lepas, serta apakah jumlah probabilitasnya sama dengan satu.
16. Penutup
Distribusi probabilitas memungkinkan kita menyatakan peluang dari seluruh kemungkinan hasil suatu percobaan atau keadaan suatu sistem.
Dalam contoh bola dan dadu, kita telah melihat bagaimana probabilitas disusun dalam tabel. Melalui Python, kita mempelajari cara menyimpan distribusi, memeriksa validitasnya, dan memperkirakannya dari data pengamatan.
Kita juga telah membedakan antara distribusi peluang dan satu hasil yang benar-benar terjadi.
Perbedaan tersebut sangat penting dalam Machine Learning karena sebuah model dapat menghasilkan distribusi probabilitas, bukan sekadar satu label prediksi.
Pada Rantai Markov, distribusi probabilitas menjadi representasi penting untuk menjelaskan peluang berbagai keadaan sistem pada waktu tertentu.
Dengan memahami konsep ini, kita telah menyiapkan fondasi untuk mempelajari vektor probabilitas dan perkalian matriks transisi secara lebih mendalam.
Pada artikel penghubung berikutnya, kita akan mengenal matriks dari tingkat paling dasar dan mempraktikkan operasi matriks menggunakan Python sebelum menghubungkannya dengan proses stokastik.
Referensi
- Grinstead, Charles M., dan J. Laurie Snell. Introduction to Probability. American Mathematical Society. Buku probabilitas terbuka.
- OpenStax. Introductory Statistics. Rice University. Materi statistika terbuka.
- Python Software Foundation. collections — Container datatypes. Dokumentasi Counter.