Pada artikel sebelumnya, kita telah mengenal Hidden Markov Model (HMM), yaitu model probabilistik yang memungkinkan komputer memperkirakan keadaan suatu sistem yang tidak dapat diamati secara langsung berdasarkan data pengamatan.
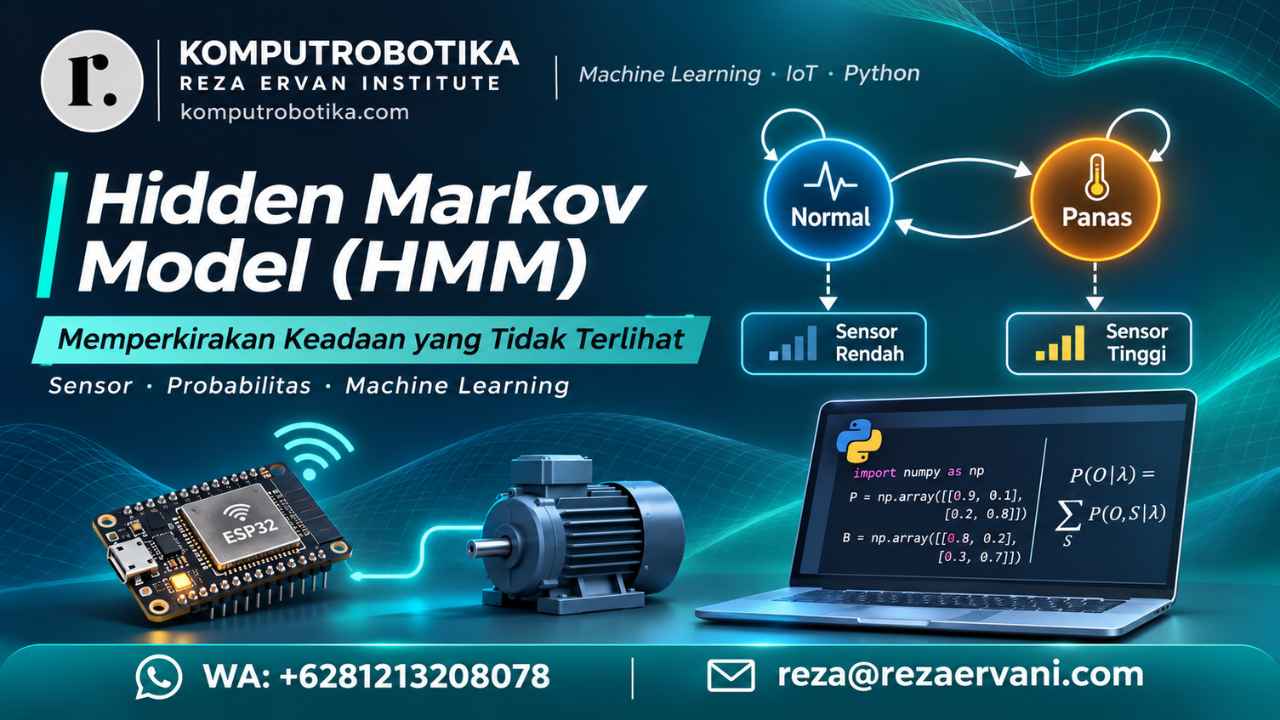
Contoh yang kita gunakan adalah sebuah motor listrik. Kondisi internal motor dianggap sebagai keadaan tersembunyi, sedangkan pembacaan sensor suhu menjadi informasi yang dapat diamati.
Kita juga telah mempelajari Forward Algorithm untuk menghitung probabilitas suatu rangkaian pengamatan serta memperkirakan keadaan sistem berdasarkan informasi yang telah diterima.
Namun, masih terdapat satu persoalan menarik.
Bayangkan kita telah mengumpulkan data sensor selama beberapa waktu. Kita ingin memperkirakan bukan hanya kondisi motor saat ini, melainkan urutan kondisi internal yang paling mungkin terjadi sepanjang periode pengamatan tersebut.
Untuk menyelesaikan persoalan ini, kita dapat menggunakan Algoritma Viterbi (Viterbi Algorithm).
1. Mengingat Kembali Hidden Markov Model
Sebelum membahas algoritmanya, kita akan menggunakan kembali parameter HMM dari artikel sebelumnya agar tidak perlu mempelajari model baru sekaligus.
Kita memiliki dua keadaan tersembunyi:
- Normal: motor berada dalam kondisi yang dikategorikan sehat.
- Panas: motor berada dalam kondisi termal yang memerlukan perhatian.
Sensor suhu menghasilkan dua kategori pengamatan, yaitu Rendah dan Tinggi.
Kita menggunakan distribusi probabilitas awal:
P(Normal) = 0.8
P(Panas)  = 0.2
Selanjutnya, kita menggunakan matriks transisi:
| Keadaan Sekarang | Berikutnya Normal | Berikutnya Panas |
|---|---|---|
| Normal | 0,9 | 0,1 |
| Panas | 0,3 | 0,7 |
Matriks tersebut menunjukkan peluang perpindahan dari satu keadaan tersembunyi menuju keadaan lainnya.
Probabilitas emisi sensor menggunakan tabel berikut:
| Keadaan Tersembunyi | Sensor Rendah | Sensor Tinggi |
|---|---|---|
| Normal | 0,80 | 0,20 |
| Panas | 0,25 | 0,75 |
Seluruh angka tersebut merupakan asumsi untuk pembelajaran, bukan hasil pengukuran karakteristik motor listrik tertentu.
Dalam penerapan nyata, parameter semacam ini harus diperkirakan dan diuji menggunakan data yang relevan.
2. Persoalan Baru: Mencari Urutan Keadaan
Anggaplah sensor menghasilkan empat pengamatan berikut:
Waktu 1 : Tinggi
Waktu 2 : Tinggi
Waktu 3 : Rendah
Waktu 4 : Tinggi
Komputer tidak dapat langsung menyimpulkan bahwa kondisi internal motor mengikuti urutan Panas, Panas, Normal, Panas.
Mengapa?
Karena pembacaan sensor dan keadaan internal merupakan dua hal yang berbeda. Dalam model kita, motor yang berada pada keadaan Normal masih memiliki peluang menghasilkan pembacaan Tinggi sebesar 20%.
Selain itu, perpindahan keadaan juga memiliki probabilitas tersendiri.
Dengan demikian, untuk menjelaskan empat pengamatan tadi, terdapat banyak kemungkinan urutan kondisi motor.
Beberapa contohnya:
Normal → Normal → Normal → Normal

Normal → Panas → Normal → Panas

Panas → Panas → Panas → Panas

Panas → Panas → Normal → Panas
Setiap urutan memiliki probabilitas gabungan yang dapat dihitung berdasarkan distribusi awal, probabilitas transisi, dan probabilitas emisi.
Tujuan Algoritma Viterbi adalah menemukan satu urutan keadaan tersembunyi yang memiliki probabilitas terbesar berdasarkan seluruh pengamatan yang tersedia.
3. Mengapa Tidak Mencoba Semua Kemungkinan?
Untuk empat waktu pengamatan dan dua kemungkinan keadaan, jumlah seluruh urutan yang mungkin adalah:
2 x 2 x 2 x 2 = 16 urutan
Enam belas urutan tentu masih memungkinkan untuk dihitung satu per satu.
Namun, bagaimana jika sensor menghasilkan 100 pengamatan?
Jumlah kemungkinan urutannya adalah:
2 pangkat 100

= 1.267.650.600.228.229.401.496.703.205.376
Jumlah tersebut sangat besar.
Jika kita mencoba menghitung setiap urutan satu per satu, kebutuhan komputasinya akan meningkat secara eksponensial seiring bertambahnya panjang pengamatan.
Di sinilah kita membutuhkan pendekatan algoritmik yang lebih efisien.
Algoritma Viterbi menggunakan teknik yang disebut dynamic programming.
4. Apa Itu Dynamic Programming?
Dynamic programming merupakan teknik algoritmik yang memanfaatkan hasil penyelesaian subpersoalan sehingga perhitungan yang sama tidak perlu diulang berkali-kali.
Dalam persoalan HMM, kita tidak perlu menyimpan seluruh kemungkinan urutan keadaan.
Pada setiap waktu, untuk setiap keadaan tersembunyi, kita cukup mempertahankan probabilitas terbesar dari jalur yang berakhir pada keadaan tersebut, beserta informasi mengenai keadaan sebelumnya yang menghasilkan nilai terbesar itu.
Mengapa pendekatan ini dapat digunakan?
Karena menurut asumsi Markov orde pertama, pengaruh keadaan sebelumnya terhadap keadaan berikutnya sudah direpresentasikan oleh keadaan saat ini.
Jika dua jalur berakhir pada keadaan yang sama pada waktu yang sama, jalur dengan skor lebih kecil tidak akan dapat mengungguli jalur dengan skor lebih besar melalui kelanjutan yang identik.
Dengan demikian, kita dapat membuang jalur yang tidak optimal tanpa kehilangan kemungkinan solusi terbaik secara keseluruhan.
Prinsip ini disebut optimal substructure, yaitu ketika solusi optimal dapat disusun dari solusi optimal subpersoalan yang relevan.
5. Menghitung Langkah Pertama
Mari kita mulai dari pengamatan pertama, yaitu Tinggi.
Jika motor berada dalam keadaan Normal, probabilitas gabungan keadaan awal Normal dan pengamatan Tinggi adalah:
0.8 x 0.20 = 0.16
Jika motor berada dalam keadaan Panas:
0.2 x 0.75 = 0.15
Hasilnya:
| Waktu | Pengamatan | Skor Jalur Normal | Skor Jalur Panas |
|---|---|---|---|
| 1 | Tinggi | 0,16 | 0,15 |
Perhatikan bahwa nilai tersebut adalah probabilitas gabungan keadaan dan pengamatan pada langkah pertama. Kita belum melakukan normalisasi untuk menghitung probabilitas keadaan bersyarat.
Selanjutnya, kita akan mempertimbangkan kemungkinan perpindahan menuju waktu kedua.
6. Menghitung Langkah Kedua
Pengamatan kedua juga menunjukkan Tinggi.
Pertama, kita ingin mencari jalur dengan skor terbesar yang berakhir pada keadaan Normal.
Terdapat dua kemungkinan:
Normal → Normal

0.16 x 0.9 x 0.20
= 0.0288
atau:
Panas → Normal

0.15 x 0.3 x 0.20
= 0.009
Jalur pertama menghasilkan skor lebih besar, sehingga kita mempertahankannya sebagai jalur terbaik menuju keadaan Normal pada waktu kedua.
Berikutnya, kita mencari jalur terbaik yang berakhir pada keadaan Panas.
Normal → Panas

0.16 x 0.1 x 0.75
= 0.012
atau:
Panas → Panas

0.15 x 0.7 x 0.75
= 0.07875
Kali ini jalur Panas menuju Panas menghasilkan skor terbesar.
Jadi, setelah pengamatan kedua, kita menyimpan:
| Keadaan Akhir | Skor Terbaik | Jalur Terbaik |
|---|---|---|
| Normal | 0,0288 | Normal → Normal |
| Panas | 0,07875 | Panas → Panas |
Perhatikan perbedaan dengan Forward Algorithm.
Forward Algorithm menjumlahkan kontribusi semua jalur yang mencapai suatu keadaan, sedangkan Viterbi hanya mempertahankan jalur dengan probabilitas terbesar.
7. Melanjutkan Perhitungan hingga Waktu Keempat
Pada waktu ketiga, sensor menunjukkan Rendah.
Untuk keadaan Normal, kita membandingkan:
Dari Normal:
0.0288 x 0.9 x 0.80
= 0.020736

Dari Panas:
0.07875 x 0.3 x 0.80
= 0.0189
Jalur dari Normal tetap menghasilkan nilai terbesar.
Untuk keadaan Panas:
Dari Normal:
0.0288 x 0.1 x 0.25
= 0.00072

Dari Panas:
0.07875 x 0.7 x 0.25
= 0.01378125
Jalur dari Panas menghasilkan nilai terbesar.
Hasil perhitungan sampai waktu keempat dapat dirangkum:
| Waktu | Sensor | Skor Terbaik Normal | Skor Terbaik Panas |
|---|---|---|---|
| 1 | Tinggi | 0,16000000 | 0,15000000 |
| 2 | Tinggi | 0,02880000 | 0,07875000 |
| 3 | Rendah | 0,02073600 | 0,01378125 |
| 4 | Tinggi | 0,00373248 | 0,00723516 |
Pada waktu keempat, jalur dengan skor terbesar adalah jalur yang berakhir pada keadaan Panas.
Namun, untuk mengetahui keseluruhan urutan keadaan, kita harus menelusuri kembali asal jalur terbaik tersebut.
Proses ini disebut backtracking.
8. Mengenal Backpointer dan Backtracking
Ketika Viterbi memilih jalur terbaik menuju suatu keadaan, algoritma juga menyimpan informasi mengenai keadaan sebelumnya yang menghasilkan skor terbesar.
Informasi tersebut disebut backpointer.
Contohnya, ketika menghitung keadaan Panas pada waktu kedua, jalur dengan skor terbaik berasal dari keadaan Panas pada waktu pertama.
Karena itu, kita menyimpan informasi bahwa keadaan Panas pada waktu kedua memiliki pendahulu Panas.
Proses ini dilakukan pada setiap waktu untuk setiap keadaan.
Setelah mencapai pengamatan terakhir, kita memilih keadaan akhir dengan skor terbesar, kemudian mengikuti backpointer secara mundur hingga waktu pertama.
Untuk model dan empat pengamatan kita, hasilnya adalah:
Pengamatan:
Tinggi → Tinggi → Rendah → Tinggi

Jalur tersembunyi terbaik:
Panas  → Panas  → Panas  → Panas
Hasil tersebut mungkin terasa mengejutkan.
Mengapa keadaan pada waktu ketiga tetap diperkirakan Panas, padahal sensor menunjukkan Rendah?
Karena Viterbi mencari urutan terbaik secara keseluruhan, bukan sekadar mencocokkan setiap pembacaan sensor dengan keadaan pada waktu yang sama.
Dalam model kita, motor yang berada pada keadaan Panas masih memiliki peluang menghasilkan pembacaan Rendah sebesar 25%.
Selain itu, mempertahankan keadaan Panas pada beberapa langkah berturut-turut memiliki probabilitas transisi yang cukup besar.
Kombinasi kedua faktor tersebut membuat jalur Panas pada keempat waktu menjadi jalur dengan probabilitas gabungan terbesar.
Perlu diingat bahwa hasil Viterbi adalah perkiraan berdasarkan model, bukan bukti bahwa motor benar-benar panas sepanjang pengamatan.
9. Praktikum Python: Membuat Algoritma Viterbi
Sekarang kita akan membuat implementasi Viterbi menggunakan Python tanpa pustaka tambahan.
Program ini menggunakan dictionary untuk menyimpan parameter HMM, tabel skor, dan backpointer.
# ==================================================
# Praktikum Algoritma Viterbi
# KOMPUTROBOTIKA
# ==================================================

states = ["Normal", "Panas"]

observations = [
    "Tinggi",
    "Tinggi",
    "Rendah",
    "Tinggi"
]

# Probabilitas awal
initial = {
    "Normal": 0.8,
    "Panas": 0.2
}

# Probabilitas transisi
transition = {
    "Normal": {
        "Normal": 0.9,
        "Panas": 0.1
    },
    "Panas": {
        "Normal": 0.3,
        "Panas": 0.7
    }
}

# Probabilitas emisi
emission = {
    "Normal": {
        "Rendah": 0.80,
        "Tinggi": 0.20
    },
    "Panas": {
        "Rendah": 0.25,
        "Tinggi": 0.75
    }
}

# Tabel skor dan backpointer
scores = []
backpointers = []

# ----------------------------------
# 1. Inisialisasi
# ----------------------------------

first_scores = {}
first_backpointers = {}

for state in states:
    first_scores[state] = (
        initial[state]
        * emission[state][observations[0]]
    )

    first_backpointers[state] = None

scores.append(first_scores)
backpointers.append(first_backpointers)

# ----------------------------------
# 2. Rekursi Viterbi
# ----------------------------------

for t in range(1, len(observations)):

    current_scores = {}
    current_backpointers = {}

    observation = observations[t]

    for current_state in states:

        candidates = {}

        for previous_state in states:

            candidates[previous_state] = (
                scores[t - 1][previous_state]
                * transition[previous_state][current_state]
                * emission[current_state][observation]
            )

        best_previous_state = max(
            candidates,
            key=candidates.get
        )

        current_scores[current_state] = (
            candidates[best_previous_state]
        )

        current_backpointers[current_state] = (
            best_previous_state
        )

    scores.append(current_scores)
    backpointers.append(current_backpointers)

# ----------------------------------
# 3. Menentukan keadaan akhir
# ----------------------------------

last_scores = scores[-1]

best_final_state = max(
    last_scores,
    key=last_scores.get
)

best_score = last_scores[best_final_state]

# ----------------------------------
# 4. Backtracking
# ----------------------------------

best_path = [best_final_state]

for t in range(len(observations) - 1, 0, -1):

    previous_state = backpointers[t][
        best_path[-1]
    ]

    best_path.append(previous_state)

best_path.reverse()

# ----------------------------------
# 5. Menampilkan hasil
# ----------------------------------

print("HASIL ALGORITMA VITERBI")
print()

for t, (observation, state) in enumerate(
    zip(observations, best_path),
    start=1
):
    print(
        f"Waktu {t}: "
        f"Sensor={observation}, "
        f"Kondisi={state}"
    )

print()
print(f"Skor jalur terbaik: {best_score:.8f}")

print()
print("TABEL SKOR")

for t, row in enumerate(scores, start=1):

    print(
        f"Waktu {t}: "
        f"Normal={row['Normal']:.8f}, "
        f"Panas={row['Panas']:.8f}"
    )
Program tersebut memiliki empat tahap utama: inisialisasi, perhitungan rekursif, pemilihan keadaan akhir, dan backtracking.
Bagian yang paling penting terdapat pada proses membandingkan kandidat jalur.
best_previous_state = max(
    candidates,
    key=candidates.get
)
Perintah tersebut memilih keadaan sebelumnya yang menghasilkan skor terbesar menuju keadaan yang sedang dihitung.
Dengan demikian, kita tidak perlu memeriksa seluruh urutan tersembunyi secara eksplisit.
10. Memahami Hasil Program
Jika program dijalankan menggunakan parameter dan data pengamatan yang sama, hasil utamanya adalah:
HASIL ALGORITMA VITERBI

Waktu 1: Sensor=Tinggi, Kondisi=Panas
Waktu 2: Sensor=Tinggi, Kondisi=Panas
Waktu 3: Sensor=Rendah, Kondisi=Panas
Waktu 4: Sensor=Tinggi, Kondisi=Panas

Skor jalur terbaik: 0.00723516

TABEL SKOR
Waktu 1: Normal=0.16000000,
         Panas=0.15000000

Waktu 2: Normal=0.02880000,
         Panas=0.07875000

Waktu 3: Normal=0.02073600,
         Panas=0.01378125

Waktu 4: Normal=0.00373248,
         Panas=0.00723516
Skor 0,00723516 merupakan probabilitas gabungan jalur tersembunyi terbaik dan rangkaian pengamatan berdasarkan parameter HMM yang digunakan.
Skor tersebut tidak boleh langsung ditafsirkan sebagai tingkat keyakinan sebesar 0,72% bahwa jalur tersebut benar.
Untuk memperoleh probabilitas jalur terbaik setelah seluruh pengamatan diketahui, skor gabungan tersebut harus dibagi dengan probabilitas total rangkaian pengamatan.
Perhitungan Forward Algorithm untuk empat pengamatan ini menghasilkan probabilitas pengamatan sebesar 0,02233733625.
Dengan demikian, probabilitas posterior dari jalur terbaik adalah sekitar:
0.00723515625 / 0.02233733625

= 0.3239

≈ 32.39%
Angka tersebut menunjukkan bahwa jalur Panas pada keempat waktu merupakan satu urutan yang paling mungkin, tetapi masih terdapat peluang gabungan yang cukup besar pada urutan-urutan lain.
Ini merupakan perbedaan penting antara menemukan solusi terbaik dan memastikan solusi tersebut benar.
11. Forward Algorithm dan Viterbi: Apa Perbedaannya?
Kedua algoritma menggunakan model HMM yang sama, tetapi menjawab pertanyaan yang berbeda.
| Aspek | Forward Algorithm | Viterbi Algorithm |
|---|---|---|
| Tujuan | Menghitung probabilitas seluruh rangkaian pengamatan | Mencari satu urutan keadaan tersembunyi terbaik |
| Operasi utama | Penjumlahan kontribusi jalur | Pemilihan nilai maksimum |
| Hasil utama | Likelihood pengamatan | Jalur terbaik dan skor gabungannya |
| Informasi tambahan | Dapat digunakan untuk estimasi keadaan berdasarkan pengamatan hingga waktu tertentu | Menggunakan backpointer untuk merekonstruksi jalur |
Forward Algorithm mempertimbangkan seluruh kemungkinan jalur dengan cara menjumlahkan kontribusinya.
Viterbi hanya mempertahankan jalur terbaik menuju setiap keadaan pada setiap waktu.
Perlu pula dibedakan antara hasil Viterbi dan pemilihan keadaan paling mungkin pada setiap waktu secara terpisah.
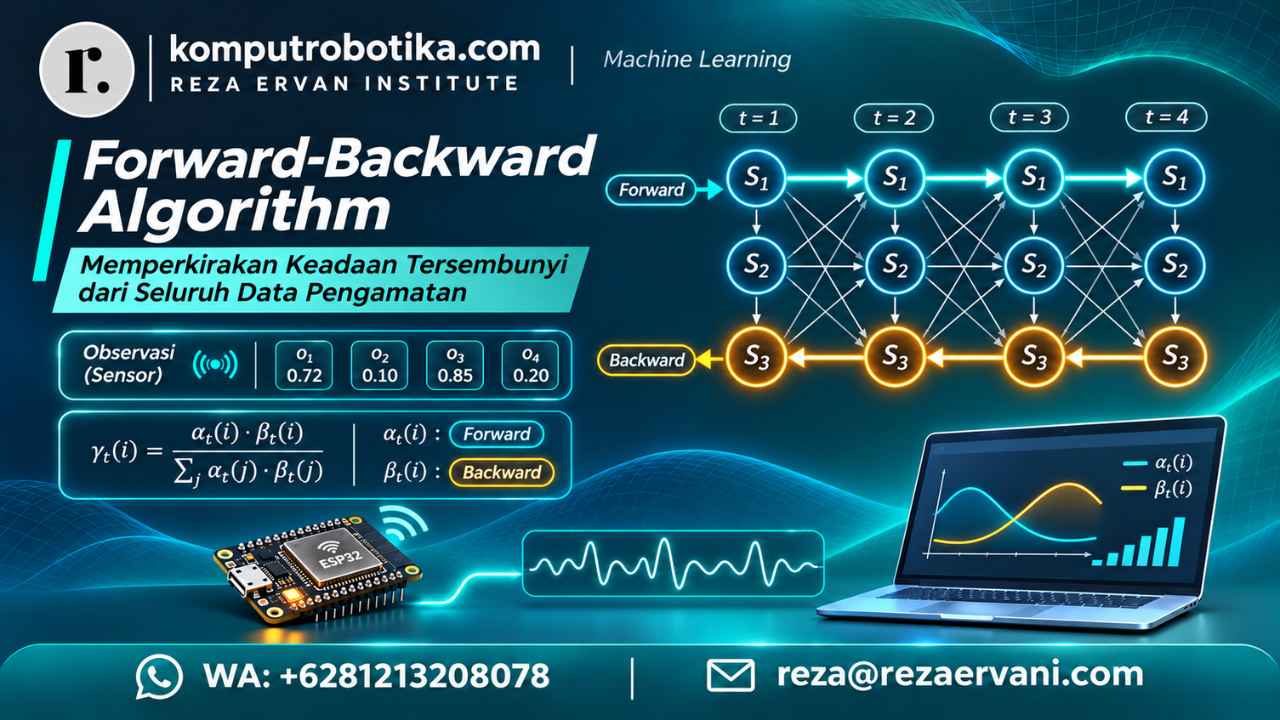
Jika kita ingin mengetahui peluang suatu keadaan berdasarkan seluruh pengamatan, termasuk pengamatan sesudah waktu tersebut, kita dapat menggunakan pendekatan Forward-Backward untuk menghitung probabilitas posterior masing-masing keadaan.
Memilih keadaan dengan posterior terbesar pada setiap waktu belum tentu menghasilkan urutan yang sama dengan Viterbi, karena Viterbi mengoptimalkan probabilitas satu urutan secara keseluruhan.
12. Seberapa Efisien Algoritma Viterbi?
Misalkan sebuah HMM memiliki N kemungkinan keadaan tersembunyi dan T waktu pengamatan.
Jika kita mencoba menghitung seluruh kemungkinan urutan secara langsung, jumlah kandidat dapat mencapai N pangkat T.
Dalam implementasi Viterbi standar, setiap waktu membutuhkan pemeriksaan kemungkinan perpindahan dari N keadaan sebelumnya menuju N keadaan sekarang.
Karena itu, kompleksitas waktunya adalah:
O(T x N^2)
Dengan menyimpan skor dan backpointer untuk setiap waktu, kebutuhan memorinya dapat mencapai:
O(T x N)
Perhatikan bahwa pertumbuhan kebutuhan komputasi menjadi jauh lebih terkendali dibandingkan pendekatan yang mencoba semua kemungkinan urutan.
Hal inilah yang membuat dynamic programming menjadi konsep penting dalam ilmu komputer.
Kita tidak sekadar membuat program yang memberikan jawaban benar, tetapi juga mempelajari bagaimana memperoleh jawaban tersebut dengan penggunaan sumber daya komputasi yang lebih efisien.
13. Hubungannya dengan IoT dan Robotika
Dalam sistem IoT, sebuah perangkat dapat menghasilkan data pengamatan secara terus-menerus.
Misalnya, sebuah ESP32 mengirim pembacaan suhu motor setiap beberapa detik ke server.
Data tersebut dapat disimpan sebagai deret waktu atau time series.
Setelah data terkumpul, HMM dan Viterbi dapat digunakan untuk memperkirakan urutan keadaan tersembunyi yang paling mungkin sesuai dengan parameter model.
Alur sederhananya adalah:
Motor Listrik
     |
     v
Sensor Suhu
     |
     v
ESP32
     |
     v
Data Deret Waktu
     |
     v
Hidden Markov Model
     |
     v
Algoritma Viterbi
     |
     v
Urutan Kondisi yang Diperkirakan
     |
     v
Analisis / Visualisasi
Hasil tersebut dapat digunakan sebagai salah satu bahan analisis dalam sistem pemantauan kondisi perangkat.
Namun, untuk membuat sistem peringatan kerusakan yang dapat dipercaya, kita masih memerlukan validasi model, data pengujian, serta pemahaman mengenai karakteristik fisis motor dan sensornya.
Dalam implementasi waktu nyata, kita juga perlu mempertimbangkan bahwa Viterbi yang menggunakan seluruh rangkaian pengamatan dapat memberikan penilaian ulang terhadap keadaan-keadaan sebelumnya ketika data baru tersedia.
Karena itu, pemrosesan secara langsung, pemrosesan dalam jendela waktu tertentu, dan analisis setelah data terkumpul memiliki kebutuhan desain yang berbeda.
14. Praktikum Lanjutan: Menguji Sensitivitas Model
Setelah program Viterbi berhasil dijalankan, kita dapat melakukan beberapa eksperimen untuk memahami bagaimana parameter model memengaruhi hasil.
- Ubah probabilitas awal Normal dan Panas menjadi masing-masing 0,5.
- Ubah probabilitas perpindahan Normal menuju Panas dari 0,1 menjadi 0,4, lalu sesuaikan peluang tetap Normal agar jumlah baris tetap 1.
- Ubah probabilitas emisi Rendah pada keadaan Panas dari 0,25 menjadi 0,05, lalu sesuaikan peluang emisi Tinggi menjadi 0,95.
- Tambahkan pengamatan Rendah beberapa kali dan periksa kapan jalur terbaik mulai berubah.
- Bandingkan hasil Viterbi dengan hasil pemilihan keadaan berdasarkan probabilitas posterior pada setiap waktu.
Eksperimen ini membantu kita memahami bahwa keluaran algoritma tidak hanya dipengaruhi data sensor, tetapi juga oleh asumsi probabilitas yang digunakan untuk memodelkan sistem.
Ketika parameter berubah, jalur terbaik yang dipilih komputer juga dapat berubah.
Dalam pembelajaran Machine Learning, hal ini mengingatkan kita bahwa pemahaman terhadap data, model, dan metode evaluasi sama pentingnya dengan kemampuan menuliskan algoritma.
15. Apa yang Belum Dipelajari?
Dalam seluruh contoh sebelumnya, kita masih menggunakan parameter probabilitas yang ditetapkan secara manual.
Padahal, jika ingin membangun model berdasarkan data pengamatan nyata, kita harus menjawab pertanyaan berikut:
Bagaimana komputer memperkirakan probabilitas transisi dan emisi ketika kondisi internal yang ingin dipelajari justru tidak diketahui secara langsung?
Persoalan ini disebut pembelajaran parameter HMM.
Salah satu algoritma yang dapat digunakan adalah Baum-Welch, yaitu penerapan Expectation-Maximization (EM) untuk memperkirakan parameter Hidden Markov Model dari data pengamatan.
Pembahasannya akan membawa kita kepada Forward-Backward Algorithm, probabilitas posterior, dan optimasi parameter model.
16. Penutup
Melalui Algoritma Viterbi, kita telah mempelajari bagaimana komputer dapat mencari urutan keadaan tersembunyi yang paling mungkin tanpa harus menghitung seluruh kombinasi secara eksplisit.
Keunggulan utamanya terletak pada penggunaan dynamic programming untuk mempertahankan hasil terbaik pada setiap subpersoalan, kemudian menyusun kembali solusi keseluruhan melalui backtracking.
Dalam contoh motor listrik, kita juga melihat bahwa hasil pembacaan sensor tidak boleh langsung disamakan dengan keadaan internal perangkat.
Komputer menggabungkan informasi pengamatan, probabilitas perubahan keadaan, dan asumsi model untuk menghasilkan perkiraan yang dapat dianalisis lebih lanjut.
Dengan demikian, pembelajaran Algoritma Viterbi tidak hanya membantu kita memahami salah satu teknik dalam Machine Learning, tetapi juga memperdalam pemahaman tentang probabilitas, algoritma, struktur data, dan efisiensi komputasi.
Pada pembahasan berikutnya, kita akan mengenal Forward-Backward Algorithm dan melihat bagaimana komputer dapat menghitung probabilitas keadaan tersembunyi menggunakan keseluruhan rangkaian pengamatan.
Referensi
- Rabiner, L. R. (1989). A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition. Proceedings of the IEEE, 77(2), 257–286. https://doi.org/10.1109/5.18626.
- Jurafsky, D., dan Martin, J. H. Speech and Language Processing: Hidden Markov Models. Stanford University. Materi PDF.